- verstehen, was Mandantenfähigkeit bedeutet und warum sie entscheidend ist
- Modelle der Mandantentrennung mit ihren Vor- und Nachteilen vergleichen
- Datenschutz durch Technikgestaltung in den Entwurf einbauen
- Löschung, Auskunft und Datenstandort technisch planen
Viele moderne Anwendungen werden nicht für einen einzelnen Kunden gebaut, sondern als Plattform für viele: eine Buchungssoftware für Hunderte Yogastudios, ein Shopsystem für Tausende Händler, eine Lernplattform für viele Schulen. Jeder dieser Kunden ist ein Mandant. Alle nutzen dieselbe Anwendung, aber keiner darf die Daten eines anderen sehen. Diese Trennung ist die wichtigste Sicherheitseigenschaft einer solchen Plattform – ein einziger Fehler, und ein Studio sieht die Mitgliederliste der Konkurrenz. Gleichzeitig verlangt der Datenschutz, personenbezogene Daten sparsam, zweckgebunden und nachvollziehbar zu verarbeiten. Beides gehört von Anfang an in den Entwurf.
1. Was Mandantenfähigkeit bedeutet
Mandantenfähigkeit hat große Vorteile: Eine Anwendung für alle ist günstiger zu betreiben, Updates erreichen alle Kunden gleichzeitig, und neue Kunden können in Minuten starten. Die Herausforderung liegt in der Trennung. Sie betrifft nicht nur die Daten, sondern auch die Leistung – ein großer Kunde mit einem riesigen Import darf die anderen nicht ausbremsen – und die Konfiguration, etwa eigene Farben, Domains oder Einstellungen je Mandant.
2. Modelle der Trennung
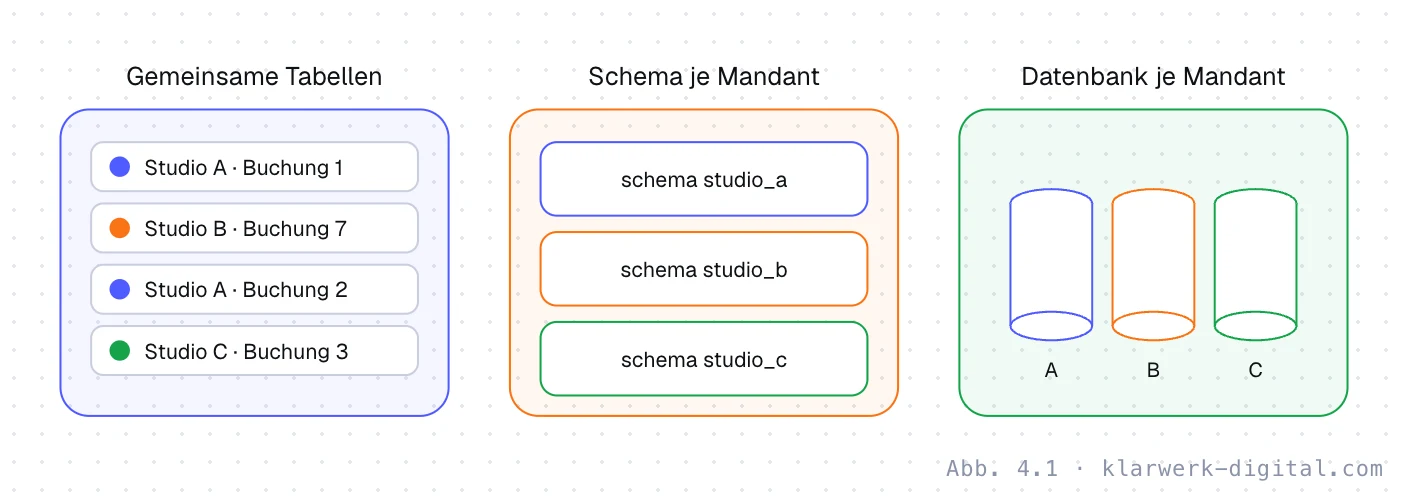
Für die Trennung der Daten gibt es drei grundlegende Modelle, die sich in Isolation, Kosten und Aufwand unterscheiden:
Isolation
Kosten
Betriebsaufwand
Für die meisten Plattformen ist das Modell gemeinsamer Tabellen der richtige Start, aber nur mit doppelter Absicherung. Erstens filtert die Anwendung jede Abfrage nach dem Mandanten, und zwar an einer zentralen Stelle, nicht in jedem Endpunkt einzeln. Zweitens erzwingt die Datenbank die Trennung selbst, etwa mit Row Level Security in PostgreSQL: Selbst wenn der Code einen Filter vergisst, liefert die Datenbank nur Zeilen des aktuellen Mandanten. Große Kunden mit besonderen Anforderungen, etwa einem eigenen Datenstandort, können später in eine eigene Datenbank umziehen – ein Mischmodell, das viele erfolgreiche Plattformen nutzen.
3. Weitere Fallstricke
Mandantentrennung scheitert selten an der Datenbank, sondern an den Rändern. Ein Cache-Schlüssel ohne Mandanten-ID liefert dem einen Studio die Kursliste des anderen. Dateien im Objektspeicher ohne Mandantenpfad sind über erratbare Adressen erreichbar. Hintergrundaufträge verlieren den Mandantenkontext. Suchindizes und Vektordatenbanken für KI-Assistenten mischen Dokumente aller Kunden, sodass der Assistent eines Studios Inhalte eines anderen zitiert. Und ein einziger „laute Nachbar“ mit einem riesigen Export belegt die gesamte Rechenleistung. Gegen Letzteres helfen Rate Limits und Kontingente je Mandant sowie getrennte Warteschlangen für große Aufträge.
| Stelle | Risiko ohne Mandanten-ID |
|---|---|
| Datenbankabfragen | fremde Datensätze sichtbar |
| Cache-Schlüssel | fremde Inhalte aus dem Cache |
| Dateipfade | Dateien anderer Kunden abrufbar |
| Such- und Vektorindex | KI-Assistent zitiert fremde Dokumente |
| Hintergrundaufträge | Export landet beim falschen Kunden |
| Logs und Metriken | Fehler nicht zuordenbar, keine Kosten je Kunde |
4. Datenschutz durch Technikgestaltung
Die DSGVO verlangt in Artikel 25 Datenschutz durch Technikgestaltung und datenschutzfreundliche Voreinstellungen. Für den Entwurf bedeutet das: Nur die Daten erheben, die für den Zweck nötig sind. Personenbezogene Daten von anderen Daten trennen, wo es geht. Zugriffe auf das Nötige beschränken und protokollieren. Speicherfristen festlegen und automatisch durchsetzen. Klicken Sie sich durch den Lebenszyklus personenbezogener Daten:
Üben Sie die Einschätzung:
Die Anmeldung fragt Geburtsdatum, Adresse und Beruf ab, obwohl nur eine E-Mail gebraucht wird
Gelöschte Konten werden nach 30 Tagen auch aus Backups entfernt oder dort unkenntlich gemacht
Die Testumgebung nutzt eine vollständige Kopie der echten Kundendatenbank
Kundendaten liegen bei einem Hoster in der EU, mit Auftragsverarbeitungsvertrag
Nutzer können ihre Daten per Klick als Datei herunterladen
5. Löschen ist ein Entwurfsthema
Das Recht auf Löschung klingt einfach, ist in verteilten Systemen aber anspruchsvoll. Daten liegen nicht nur in der Hauptdatenbank, sondern auch in Replikaten, Caches, Suchindizes, Vektordatenbanken, Logs, Ereignisströmen, Backups und bei externen Dienstleistern. Ein Löschkonzept legt fest, wo welche Daten liegen, wie lange sie aufbewahrt werden und wie eine Löschung alle Stellen erreicht. Bewährte Techniken sind Ereignisse wie „Konto gelöscht“, auf die alle Dienste reagieren, Pseudonymisierung in Logs und Analysen, sodass dort gar keine direkten Personenbezüge entstehen, und bei unveränderlichen Speichern die Verschlüsselung mit einem Schlüssel je Nutzer, der bei Löschung vernichtet wird.
6. Datenstandort und Dienstleister
Für viele Kunden, besonders Behörden, Praxen und größere Unternehmen, ist der Datenstandort ein Entscheidungskriterium. Ein Entwurf sollte deshalb festhalten, wo Daten gespeichert und verarbeitet werden, welche Dienstleister Zugriff haben und auf welcher Grundlage. Mit jedem Anbieter, der personenbezogene Daten verarbeitet – Hoster, E-Mail-Versand, Analyse, KI-Modell –, braucht es einen Auftragsverarbeitungsvertrag. Bei Diensten außerhalb der EU kommen weitere Prüfungen hinzu. Für eine Plattform, die Arztpraxen oder Schulen bedient, kann das den Ausschlag geben, einen europäischen Anbieter oder ein Modell in eigener Infrastruktur zu wählen. Solche Entscheidungen früh zu treffen und zu dokumentieren, erspart später aufwendige Umzüge und macht die Plattform für anspruchsvolle Kunden überhaupt erst verkaufbar.
7. Ein Beispiel
Eine Softwarefirma entwickelt eine Kursverwaltung für Tanz- und Yogastudios. Zum Start mit zwanzig Studios wählt sie gemeinsame Tabellen mit einer Spalte für den Mandanten und aktiviert Row Level Security in PostgreSQL. Jede Anfrage setzt zu Beginn den aktuellen Mandanten in der Datenbankverbindung; vergisst der Code einen Filter, liefert die Datenbank trotzdem nur passende Zeilen. Cache-Schlüssel, Dateipfade und der Suchindex für den KI-Assistenten enthalten die Mandanten-ID. Ein automatischer Test legt zwei Studios an und prüft bei jedem Endpunkt, dass Studio A niemals Daten von Studio B erhält.
Für den Datenschutz erhebt die Anmeldung nur Name und E-Mail, optionale Angaben wie Telefonnummer sind klar gekennzeichnet. Kundendaten liegen bei einem Hoster in Deutschland, mit allen Dienstleistern bestehen Auftragsverarbeitungsverträge. Mitglieder können ihre Daten selbst herunterladen und ihr Konto löschen; ein Ereignis „Mitglied gelöscht“ sorgt dafür, dass auch Suchindex, Newsletter-Dienst und Analysen bereinigt werden. Zwei Jahre später kommt eine große Fitnesskette mit dem Wunsch nach einer eigenen Datenbank hinzu. Weil die Mandanten-ID überall konsequent geführt wurde, lässt sich ihr Datenbestand mit überschaubarem Aufwand in eine eigene Instanz verschieben – ein Auftrag, der ohne diese Vorbereitung womöglich an der Technik gescheitert wäre.
Mandantenfähigkeit und Datenschutz sind damit zwei Seiten derselben Medaille: Beide verlangen, genau zu wissen, wo welche Daten liegen, wem sie gehören und wer darauf zugreifen darf. Wer das im Entwurf klärt, baut eine Plattform, der Kunden vertrauen können.
- [1]Verordnung (EU) 2016/679 (DSGVO), Art. 5, 17, 20, 25, 28.
- [2]PostgreSQL Global Development Group (2026): Row Security Policies. PostgreSQL Documentation.
- [3]Amazon Web Services (2023): SaaS Tenant Isolation Strategies – Whitepaper.
- [4]Datenschutzkonferenz (2020): Das Standard-Datenschutzmodell, Version 2.0b.
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.