Eine Lern-App ohne Ton ist wie ein Sprachkurs ohne Lehrer: Man sieht die Wörter, aber man hört sie nie. Früher hieß das, Sprecher ins Studio zu holen und jede Zeile einzeln aufzunehmen. Heute schickt man den Text an eine Schnittstelle und bekommt Sekunden später eine Aufnahme zurück, die nach einem Menschen klingt. Der bekannteste Anbieter dafür ist ElevenLabs. Dieser Beitrag erklärt, wie die Vertonungs-API funktioniert, was sie kostet und worauf es beim Einbau ankommt – am Beispiel von zwei Plattformen, die wir selbst gebaut und komplett mit ElevenLabs vertont haben: Habloo mit der englischsprachigen Fassung habloo.net und Davaigo.
Was die Vertonungs-API macht
Das Prinzip ist einfach: Text rein, Audio raus. Sie schicken einen Satz, wählen eine Stimme und ein Modell und erhalten eine fertige Audiodatei zurück, standardmäßig als MP3 mit 44,1 kHz und 128 kbit/s. Abgerechnet wird nach Zeichen – ein kurzes Wort kostet also fast nichts, ein langer Absatz entsprechend mehr.
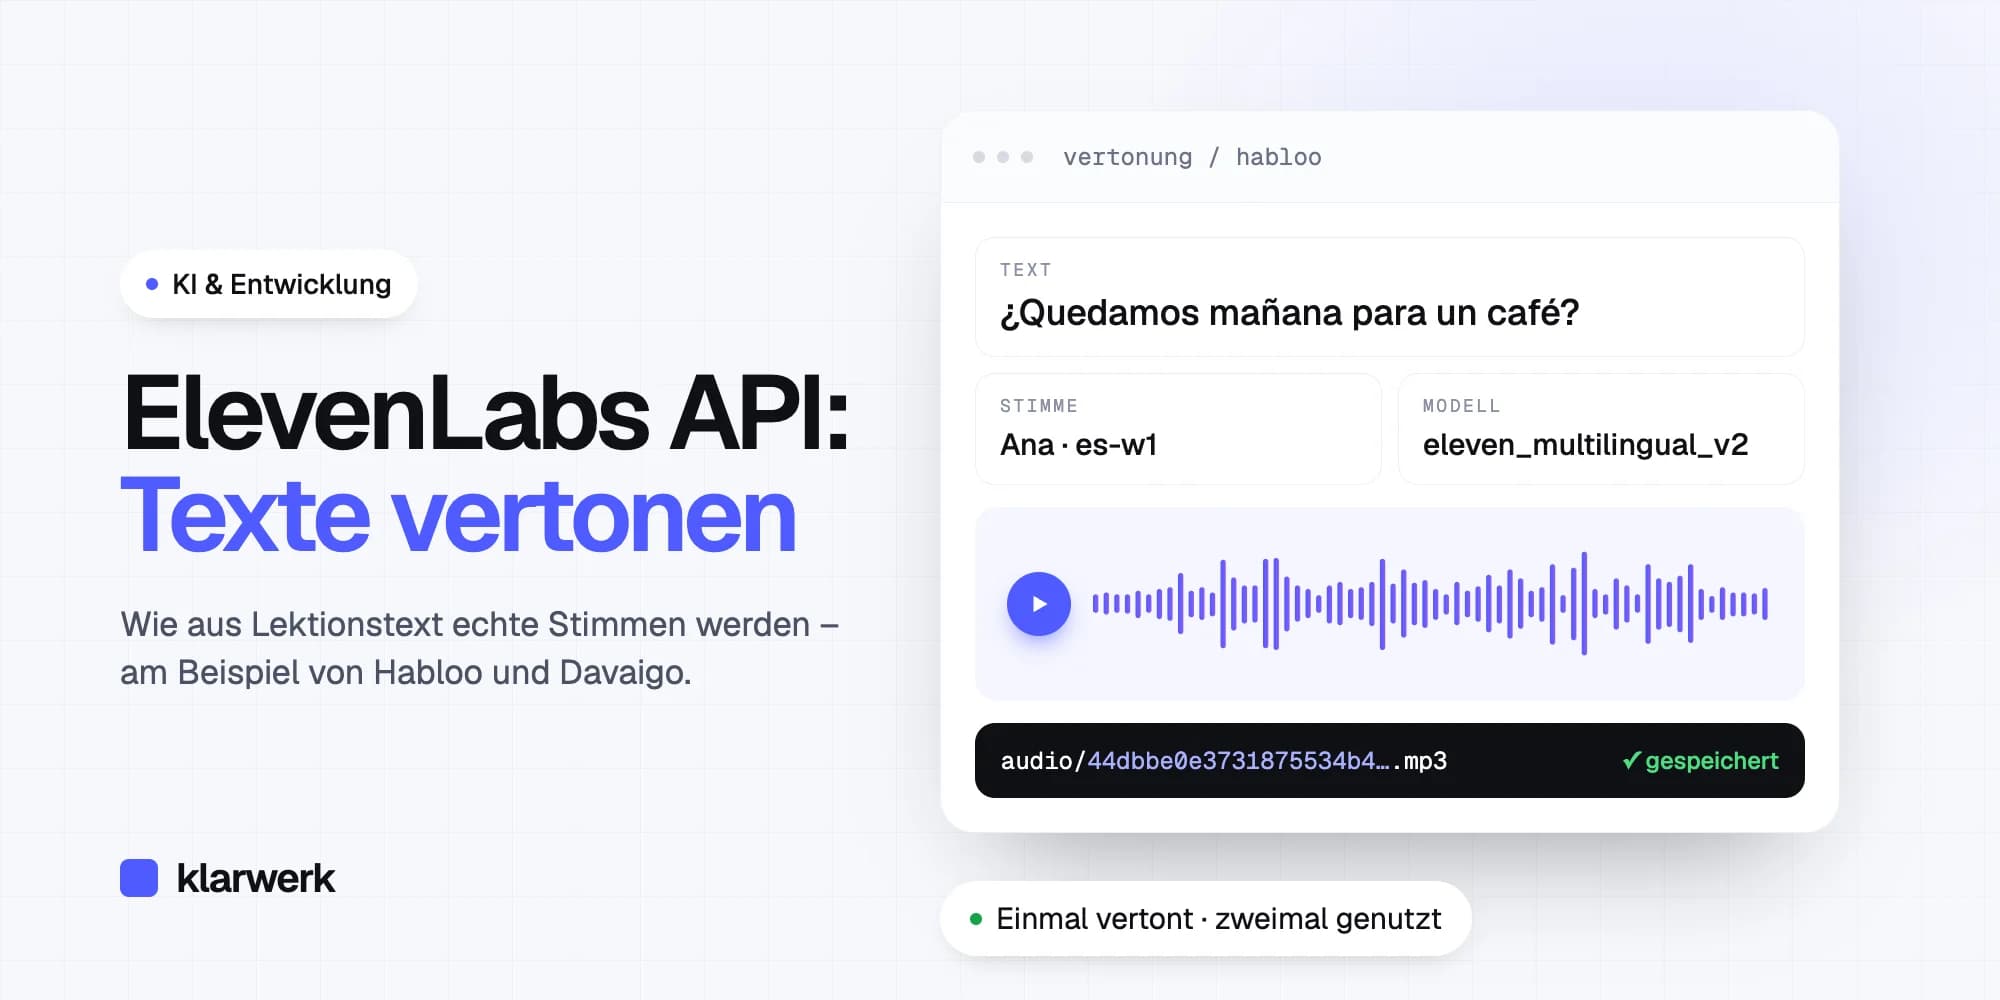
Technisch ist es ein einziger Aufruf. Die Adresse enthält die Kennung der Stimme, der Schlüssel steht im Kopf der Anfrage, Text und Modell im Inhalt. So sieht der Aufruf aus, mit dem wir die Spanisch-Plattform Habloo vertont haben:
const antwort = await fetch(
  "https://api.elevenlabs.io/v1/text-to-speech/" + stimmeId + "?output_format=mp3_44100_128",
  {
    method: "POST",
    headers: { "xi-api-key": process.env.ELEVENLABS_API_KEY, "Content-Type": "application/json" },
    body: JSON.stringify({
      text: "¿Quedamos mañana para un café?",
      model_id: "eleven_multilingual_v2",
      voice_settings: { stability: 0.55, similarity_boost: 0.8 },
    }),
  }
);
const mp3 = Buffer.from(await antwort.arrayBuffer());
Mit den Stimmeinstellungen steuern Sie, wie gleichmäßig eine Stimme klingt. Ein höherer Wert bei stability sorgt dafür, dass derselbe Sprecher über Tausende Aufnahmen hinweg gleich klingt – für einen Kurs wichtiger als dramatischer Ausdruck. Mit similarity_boost bleibt die Aufnahme nah am Original der gewählten Stimme. Zusätzlich gibt es Angaben zu Tempo und Stil sowie die Möglichkeit, den Text davor und danach mitzuschicken, damit die Betonung über mehrere Anfragen hinweg zusammenpasst.
Die Modelle im Überblick
ElevenLabs bietet mehrere Sprachmodelle an, die sich in Klang, Sprachen und Geschwindigkeit unterscheiden. Für vorab erzeugte Aufnahmen zählt Qualität, für Echtzeit-Anwendungen wie einen sprechenden Assistenten zählt die Antwortzeit. Stand September 2026:
| Modell | Sprachen | Zeichen je Anfrage | Stärke |
|---|---|---|---|
| eleven_multilingual_v2 | 29 | 10.000 | gleichbleibende Qualität, lange Texte – Standard der API |
| eleven_v3 | über 70 | 5.000 | ausdrucksstark, Dialoge mit mehreren Sprechern |
| eleven_v4 | über 90 | 10.000 | neuestes Modell, am ausdrucksstärksten |
| eleven_flash_v2_5 | 32 | 40.000 | sehr schnell, halber Preis – für Echtzeit |
Für Lerninhalte haben wir uns bewusst für Multilingual v2 entschieden. Das Modell klingt über viele kurze Schnipsel hinweg am gleichmäßigsten, und genau das braucht ein Kurs: Wer eine Vokabel zum zehnten Mal hört, soll nicht jedes Mal eine leicht andere Betonung bekommen. Die älteren Turbo-Modelle empfiehlt ElevenLabs inzwischen nicht mehr; ihr Nachfolger ist Flash.
Die richtige Stimme finden
Die wichtigste Entscheidung fällt nicht im Code, sondern beim Hören. In der Stimmenbibliothek von ElevenLabs stehen Tausende Stimmen bereit, sortiert nach Sprache, Akzent und Charakter. Jede hat eine Kennung, die Sie im Aufruf angeben. Wir wählen Stimmen nie nach der Beschreibung aus, sondern nach Hörproben mit echten Sätzen aus dem Kurs.
Wie wichtig das ist, haben wir bei Habloo gelernt. Die erste Besetzung bestand aus zwei Standardstimmen mit englischem Akzent. Für einen Kurs, der Spanisch aus Spanien lehrt – mit vosotros, vale und Tapas –, passte das nicht. Heute sprechen fünf Stimmen mit echtem Spanien-Spanisch die Rollen der Lektionen: die Hauptfigur Ana, der Lernende Tom, ein Valencianer mit lockerem Ton und zwei weitere Figuren. Bei Davaigo sprechen zwei russische Muttersprachler; beide Stimmen wurden vor dem Vertonen per Hörprobe abgenommen.
Praxisbeispiel 1: Habloo und habloo.net
Habloo ist eine Spanisch-Lernplattform mit Lektionen, Dialogen, Hörszenen und Karteikarten. Jede Vokabel, jeder Beispielsatz und jede Dialogzeile hat eine eigene Aufnahme – zusammen rund 4.700 Dateien. Allein die Beispielsätze sind 1.724 Sätze mit rund 47.600 Zeichen, mehr als Dialoge und Vokabeln zusammen.
Für die englischsprachige Fassung habloo.net wird davon nichts neu vertont. Die spanischen Sätze bleiben gleich, nur die Übersetzung wechselt von Deutsch zu Englisch. Weil jede Aufnahme über eine Prüfsumme aus Stimme und Text benannt ist, kann die neue Plattform die vorhandenen Dateien direkt übernehmen – sie rechnet für denselben Satz denselben Dateinamen aus. Einmal vertont, zweimal genutzt: Das ist der größte Vorteil einer sauber geplanten Audio-Ablage.
Praxisbeispiel 2: Davaigo
Davaigo ist das russische Gegenstück: 180 Lektionen in zehn Modulen, vom kyrillischen Alphabet bis zum natürlichen Russisch auf B2-Niveau. Für alle Lektionen hat ElevenLabs 4.178 Aufnahmen erzeugt – zusammen 67.916 Zeichen, rund 103 Megabyte an MP3-Dateien. Die englischsprachige Plattform davaigo.com nutzt dieselben Dateien über denselben Prüfsummen-Namen.
Rechnet man die 67.916 Zeichen zum Listenpreis der API für Multilingual v2 (0,08 US-Dollar je 1.000 Zeichen), kommt man auf rund 5,40 US-Dollar für den kompletten Kurs. Die Vertonung selbst ist also nicht der Kostenfaktor. Aufwand steckt in der Auswahl der Stimmen, in der Organisation der Dateien und darin, dass am Ende keine einzige Aufnahme fehlt.
Zeichen gesamt
67.916
Multilingual v2 / v3
5,43 $
Flash v2.5
2,72 $
Sechs Regeln, die sich bewährt haben
1. Vorab vertonen statt live
Wir erzeugen alle Aufnahmen einmal und legen sie als Dateien ab. Beim Lernen wird nichts an ElevenLabs geschickt. Das spart laufende Kosten und Wartezeit – und es hat einen Datenschutz-Vorteil: Weil keine Nutzerdaten an den Dienst gehen, taucht ElevenLabs in der Datenschutzerklärung von Habloo gar nicht als Empfänger auf.
2. Die Prüfsumme ist der Dateiname
Jede Aufnahme heißt so wie die Prüfsumme aus Besetzungsstand, Stimme und Text. Ändert sich ein Satz in einer Lektion, ändert sich automatisch der Dateiname. Die App findet dann keine veraltete Aufnahme mehr, und das Skript weiß, dass es diesen Satz neu vertonen muss. Es kann also nie eine Aufnahme laufen, die nicht zum Text passt.
audio/
…
Ändern Sie ein einziges Zeichen, die Stimme oder den Besetzungsstand: Der Name ändert sich komplett. Das Vertonungsskript sieht dann, dass diese Datei fehlt, und erzeugt sie neu – eine veraltete Aufnahme kann nie zum Text passen.
3. Die Besetzung ist eine Zahl
Welche Stimme hinter welcher Rolle steckt, steht in einer eigenen Datei, nicht im Code. Wechselt die Besetzung, wird eine Zahl hochgezählt, die in jede Prüfsumme eingeht. Dadurch bekommen alle Dateien neue Namen, und der nächste Lauf vertont alles neu. Ohne diese Zahl würde das Skript die alten Aufnahmen für aktuell halten, und die App spielte für immer die alte Stimme.
4. Erst der Probelauf, dann die Rechnung
Unser Vertonungsskript prüft zuerst, welche Dateien schon im Speicher liegen, und zeigt an, wie viele Zeichen fehlen. Erst mit einem ausdrücklichen Befehl wird wirklich vertont. So wissen Sie vor jedem Lauf, was er kostet.
5. Mit Geduld bei Fehlern
Bei Tausenden Aufrufen ist ein Aussetzer sicher. Meldet die Schnittstelle „zu viele Anfragen“ oder einen Serverfehler, wartet das Skript und versucht es erneut. Bei allen anderen Fehlern bricht es sofort ab, denn ein falscher Schlüssel wird beim zweiten Versuch nicht richtig. Auch das Hochladen wird wiederholt – die Aufnahme ist zu diesem Zeitpunkt schon bezahlt.
6. Ein Rückfall für jede Lücke
Fehlt eine Datei, spricht die App den Text mit der eingebauten Stimme des Geräts. Das klingt schlechter, aber der Hörknopf funktioniert immer. Sobald die Aufnahme nachgeliefert ist, kommt automatisch die echte Stimme.
Was es kostet
ElevenLabs rechnet nach Zeichen ab. Zum Listenpreis der API kosten die Modelle Multilingual v2 und v3 0,08 US-Dollar je 1.000 Zeichen, Flash die Hälfte. Für das neue Modell v4 läuft im September 2026 ein Aktionspreis. Daneben gibt es Abos mit monatlichem Kontingent, von Starter für 6 US-Dollar über Creator für 22 US-Dollar bis zu Tarifen für Unternehmen. Habloo wurde im Creator-Tarif vertont. Maßgeblich sind immer die aktuellen Preise auf der Seite des Anbieters.
Wichtig für den geschäftlichen Einsatz: Der kostenlose Tarif enthält keine kommerzielle Lizenz, und veröffentlichte Inhalte müssen dort mit „elevenlabs.io“ gekennzeichnet werden. Alle bezahlten Tarife schließen die kommerzielle Nutzung ein – auch über das Ende des Abos hinaus für alles, was während der Laufzeit erzeugt wurde.
Kennzeichnung und Datenschutz
Seit dem 2. August 2026 gelten die Transparenzpflichten aus Artikel 50 der KI-Verordnung. Anbieter wie ElevenLabs müssen synthetische Audioinhalte maschinenlesbar kennzeichnen. Wer Inhalte veröffentlicht, die täuschend echt wirken und reale Personen nachahmen, muss offenlegen, dass sie künstlich erzeugt sind. Unabhängig davon, ob die Pflicht im Einzelfall greift, empfehlen wir einen kurzen, sichtbaren Hinweis wie „Sprachaufnahmen mit KI erzeugt“. Er kostet nichts und schafft Vertrauen. Mehr dazu im Beitrag zur KI-Kennzeichnungspflicht auf der Website.
Beim Datenschutz macht die Bauweise den Unterschied. Wer vorab vertont, schickt nur eigene Lerninhalte an den Dienst, keine Daten von Nutzern. Wer dagegen live vertont – etwa die Antworten eines Chatbots –, gibt womöglich personenbezogene Inhalte weiter und braucht einen Vertrag zur Auftragsverarbeitung. Eine eigene Stimme klonen zu lassen, ist technisch möglich. Mit der Stimme einer anderen Person geht das nur mit ihrer ausdrücklichen Einwilligung.
Wann sich die Vertonung lohnt
Am meisten bringt die API dort, wo viele kurze Texte in gleichbleibender Qualität gesprochen werden müssen: Sprachkurse, Schulungen, Produkterklärungen, Vorlesefunktionen für eine barrierefreie Website oder eine wöchentliche Audio-Zusammenfassung. Weniger geeignet ist sie für Inhalte, die von einer echten Person leben, etwa ein Grußwort der Geschäftsführung. Dort wirkt eine erzeugte Stimme schnell unpersönlich, auch wenn sie technisch einwandfrei klingt.
Häufige Fragen
Was ist die ElevenLabs API?
Eine Programmierschnittstelle, über die Software Texte in gesprochene Sprache umwandeln lässt. Sie schicken Text, Stimme und Modell und erhalten eine Audiodatei zurück, zum Beispiel als MP3. Abgerechnet wird nach Zeichen.
Welches Modell sollte ich für Lerninhalte nehmen?
Für vorab erzeugte Aufnahmen hat sich Multilingual v2 bewährt, weil es über viele kurze Texte sehr gleichmäßig klingt. Für Echtzeit-Anwendungen wie einen sprechenden Assistenten ist Flash die bessere Wahl, weil es deutlich schneller antwortet und nur die Hälfte kostet.
Was kostet es, einen ganzen Kurs zu vertonen?
Weniger als oft gedacht. Die 180 Lektionen von Davaigo haben 67.916 Zeichen; das entspricht zum Listenpreis der API rund 5,40 US-Dollar. Der eigentliche Aufwand liegt in Stimmauswahl, Ablage und Qualitätskontrolle.
Darf ich die Aufnahmen kommerziell nutzen?
Mit einem bezahlten Tarif ja, auch nach dem Ende des Abos für alles, was während der Laufzeit erzeugt wurde. Im kostenlosen Tarif ist die kommerzielle Nutzung ausgeschlossen, und veröffentlichte Inhalte müssen ElevenLabs nennen.
Muss ich KI-Stimmen kennzeichnen?
Die KI-Verordnung verlangt seit dem 2. August 2026 Transparenz, besonders bei Inhalten, die täuschend echt wirken und reale Personen nachahmen. Wir empfehlen, KI-Stimmen immer sichtbar zu kennzeichnen – ein kurzer Hinweis genügt.
Kann ich die Aufnahmen auf mehreren Plattformen nutzen?
Ja, wenn die Ablage darauf ausgelegt ist. Bei Habloo und Davaigo trägt jede Datei die Prüfsumme aus Stimme und Text als Namen. davaigo.com spielt dadurch die Aufnahmen der Davaigo-App ab, und habloo.net übernimmt die spanischen Aufnahmen von Habloo auf dieselbe Weise.