- verstehen, warum große Dateien nicht in die Datenbank gehören
- die Eigenschaften von Objektspeichern wie S3 kennen
- Uploads mit signierten URLs sicher und skalierbar gestalten
- Verarbeitung, Auslieferung und Lebenszyklus von Dateien planen
Fast jede Anwendung arbeitet mit Dateien: Profilbilder, Produktfotos, PDFs, Audioaufnahmen, Videos, Exporte, Backups. Die naheliegende Lösung, sie einfach in der Datenbank oder im Dateisystem des Anwendungsservers zu speichern, funktioniert am Anfang, führt aber schnell zu Problemen: Die Datenbank wird riesig und Backups dauern Stunden, Dateien verschwinden beim Neustart eines Containers, und mehrere Server sehen nicht dieselben Dateien. Die bewährte Lösung ist ein Objektspeicher. Diese Lektion zeigt, wie er funktioniert und wie man Uploads und Auslieferung sauber gestaltet.
1. Was ein Objektspeicher ist
Objektspeicher sind für eine bestimmte Aufgabe optimiert: große Mengen von Dateien zuverlässig speichern und ausliefern. Sie kennen keine Ordnerstruktur im eigentlichen Sinn, auch wenn Schlüssel wie „nutzer/4711/profil.jpg“ so aussehen, und sie unterstützen keine Änderungen innerhalb einer Datei – ein Objekt wird immer als Ganzes geschrieben oder ersetzt. Dafür speichern sie Daten mehrfach redundant, oft mit einer ausgewiesenen Dauerhaftigkeit von elf Neunen, und skalieren ohne jede Verwaltung.
Profilbilder der Nutzer
Titel, Beschreibung und Preis eines Produkts
Hochgeladene Audioaufnahmen für eine Sprachlern-App
Nächtliche Datenbank-Backups
3D-Modelle und Texturen eines Produktkonfigurators
2. Uploads mit signierten URLs
Der naheliegende Weg für Uploads – der Browser schickt die Datei an den Anwendungsserver, der sie weiter an den Objektspeicher gibt – hat Nachteile. Große Dateien belegen Speicher, Bandbreite und Verbindungen des Servers, Uploads blockieren Worker, und Zeitlimits von Load Balancern brechen lange Uploads ab. Der bessere Weg sind signierte URLs.
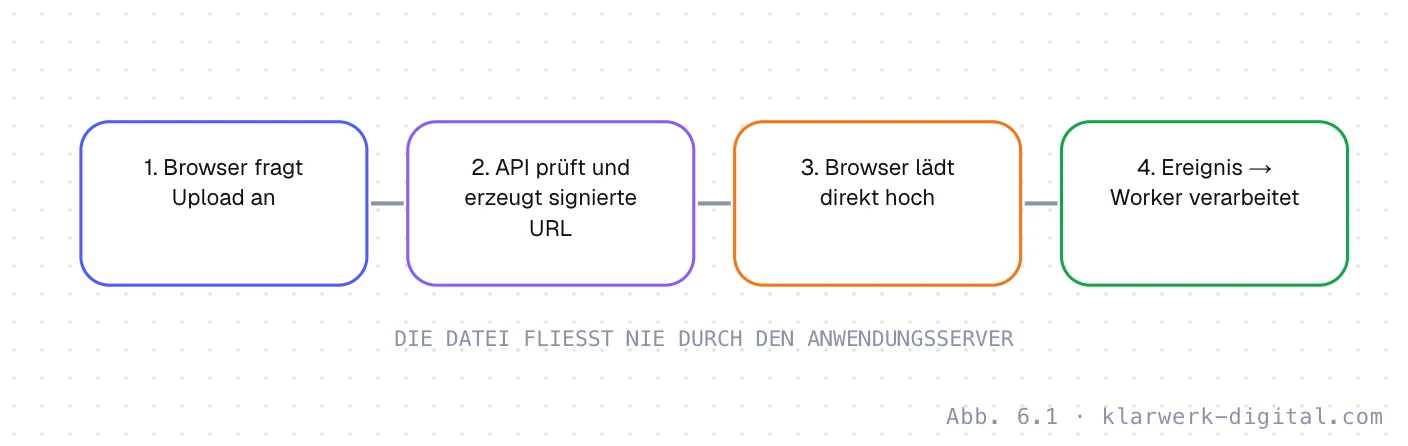
Der Ablauf: Der Browser meldet der Anwendung, dass er eine Datei hochladen möchte, und nennt Typ und Größe. Die Anwendung prüft die Berechtigung und die Angaben, legt einen Datensatz mit Status „ausstehend“ an und erzeugt eine signierte URL, die für wenige Minuten gültig ist und nur das Hochladen genau dieses Objekts erlaubt. Der Browser lädt die Datei direkt dorthin. Nach dem Upload löst der Objektspeicher ein Ereignis aus, oder der Browser meldet den Abschluss, und ein Worker prüft die Datei – tatsächlicher Dateityp, Größe, gegebenenfalls Virenscan – und verarbeitet sie weiter, etwa zu Vorschaubildern oder einer Transkription. Erst dann wird der Status auf „bereit“ gesetzt.
3. Verarbeitung und Auslieferung
Nach dem Upload folgt oft eine Verarbeitung: Bilder werden in mehrere Größen und moderne Formate umgewandelt, Videos in Streaming-Formate, Audio transkribiert, PDFs in Vorschauen. Diese Arbeit ist rechenintensiv und gehört, wie im vorigen Modul beschrieben, in Hintergrund-Worker, nie in die Anfrage selbst. Für die Auslieferung sitzt vor dem Objektspeicher idealerweise ein CDN, das Dateien nahe bei den Nutzern zwischenspeichert. Öffentliche Dateien wie Produktbilder können dauerhaft gecacht werden. Private Dateien wie Rechnungen oder persönliche Aufnahmen werden über kurzlebige signierte Download-URLs ausgeliefert, die die Anwendung nach einer Berechtigungsprüfung erzeugt.
| Baustein | Aufgabe |
|---|---|
| Objektspeicher | dauerhafte Ablage der Originale und Varianten |
| Datenbank | Verweis, Eigentümer, Status, Metadaten, Berechtigungen |
| Signierte URLs | zeitlich begrenzter Upload und Download ohne Umweg über den Server |
| Worker | Prüfung, Umwandlung, Vorschauen, Transkription |
| CDN | schnelle, entlastende Auslieferung |
| Lebenszyklusregeln | automatisches Verschieben in günstigere Klassen oder Löschen |
4. Lebenszyklus, Kosten und Datenschutz
Dateien sammeln sich an. Ohne Regeln wächst der Speicher unbegrenzt, und mit ihm die Kosten und die Risiken. Objektspeicher bieten Lebenszyklusregeln: Unvollständige Uploads werden nach einem Tag gelöscht, alte Versionen nach dreißig Tagen, selten genutzte Dateien werden in günstigere Speicherklassen verschoben. Wichtig ist auch der Datenschutz. Wenn ein Nutzer sein Konto löscht, müssen auch seine Dateien gelöscht werden – einschließlich aller Varianten, Vorschauen und Kopien im CDN. Das gelingt nur, wenn die Datenbank zuverlässig festhält, welche Objekte zu wem gehören. Ein einheitliches Schema für Schlüssel, etwa mit der Nutzer- oder Mandanten-ID als Präfix, erleichtert das erheblich.
Bei den Kosten sollte man neben dem Speicher vor allem den ausgehenden Datenverkehr im Blick behalten. Bei manchen Anbietern ist er teurer als die Speicherung selbst. Ein CDN senkt diese Kosten, und einige Anbieter verzichten ganz auf Gebühren für ausgehenden Verkehr. Für Anwendungen mit vielen großen Dateien, etwa Video- oder 3D-Inhalten, kann die Wahl des Anbieters die Betriebskosten stark beeinflussen. Auch der Speicherort ist wichtig: Für personenbezogene Daten sollte der Objektspeicher in einer europäischen Region liegen, um die Anforderungen der DSGVO einfach zu erfüllen.
5. Zusammenfassung für den Entwurf
Im Systementwurf gilt für Dateien eine einfache Aufteilung: Die Datei selbst liegt im Objektspeicher, alles Wissen über die Datei – wem sie gehört, welchen Status sie hat, welche Varianten es gibt – liegt in der Datenbank. Uploads laufen direkt über signierte URLs, Verarbeitung in Workern, Auslieferung über ein CDN. Mit diesem Muster lassen sich vom Profilbild bis zum Videoportal fast alle Anforderungen erfüllen, und die Anwendungsserver bleiben schlank, zustandslos und gut skalierbar. In der nächsten Lektion geht es um eine andere Art von Datenzugriff: die Suche.
Ein letzter praktischer Punkt betrifft Sicherheit und Missbrauch. Offene Upload-Funktionen ziehen Missbrauch an: sehr große Dateien, massenhafte Uploads, schädliche Inhalte. Begrenzungen der Dateigröße in der signierten URL, eine Obergrenze für Uploads pro Nutzer und Zeitraum, eine Prüfung des tatsächlichen Dateityps anhand des Inhalts statt der Endung und bei Bedarf ein Virenscan gehören deshalb zum Standard. Für nutzergenerierte Inhalte, die öffentlich sichtbar werden, kommt je nach Anwendung eine Moderation hinzu. Wer diese Punkte von Anfang an einplant, verhindert, dass der Objektspeicher zum Einfallstor für Angriffe oder zum Kostentreiber wird.
Eine hilfreiche Übung zum Abschluss: Gehen Sie die Dateien Ihrer eigenen Anwendung durch und prüfen Sie für jede Art, wo sie liegt, wer darauf zugreifen darf, wie sie hochgeladen und ausgeliefert wird und wann sie gelöscht wird. Häufig zeigen sich dabei Dateien im Dateisystem eines Servers, öffentlich erreichbare private Dokumente oder Uploads ohne jede Prüfung. Jede dieser Lücken lässt sich mit den Mustern dieser Lektion schließen, meist mit überschaubarem Aufwand und großem Gewinn für Sicherheit, Skalierbarkeit und Betrieb.
Denken Sie auch an die Menschen, die die Dateien später verwalten. Eine einfache Übersicht im Administrationsbereich – welche Dateien gibt es, wie groß sind sie, wem gehören sie, welcher Verarbeitungsschritt ist fehlgeschlagen – spart im Alltag viel Zeit bei der Fehlersuche und bei Anfragen von Nutzern zu ihren Daten. Auch Auskunftsersuchen nach der DSGVO lassen sich so schnell und vollständig beantworten, weil jederzeit klar ist, welche Dateien zu einer Person gehören und wo sie liegen und wie sie gelöscht werden.
- [1]Amazon Web Services (2026): Amazon S3 User Guide – Presigned URLs; Lifecycle Configuration; Data Durability.
- [2]OWASP Foundation (2024): File Upload Cheat Sheet.
- [3]Kleppmann, M. (2017): Designing Data-Intensive Applications. Sebastopol: O'Reilly, Kap. 10.
- [4]Verordnung (EU) 2016/679 (DSGVO), Art. 17 (Recht auf Löschung), Art. 44 ff.
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.