- Replikation und Sharding unterscheiden und ihren Zweck kennen
- synchrone und asynchrone Replikation mit ihren Abwägungen einordnen
- Replikationsverzögerung im Anwendungsdesign berücksichtigen
- einen geeigneten Shard-Schlüssel wählen und die Kosten von Sharding einschätzen
Irgendwann reicht ein einzelner Datenbankserver nicht mehr – weil zu viele Anfragen kommen, weil die Daten zu groß werden oder weil ein Ausfall des einen Servers das ganze System lahmlegen würde. Für diese Probleme gibt es zwei grundlegende Techniken: Replikation kopiert dieselben Daten auf mehrere Server, Sharding verteilt unterschiedliche Daten auf mehrere Server. Beide lösen verschiedene Probleme und bringen eigene Schwierigkeiten mit sich. Wichtig vorweg: Die meisten Anwendungen brauchen für lange Zeit höchstens Replikation und nie Sharding.
1. Replikation
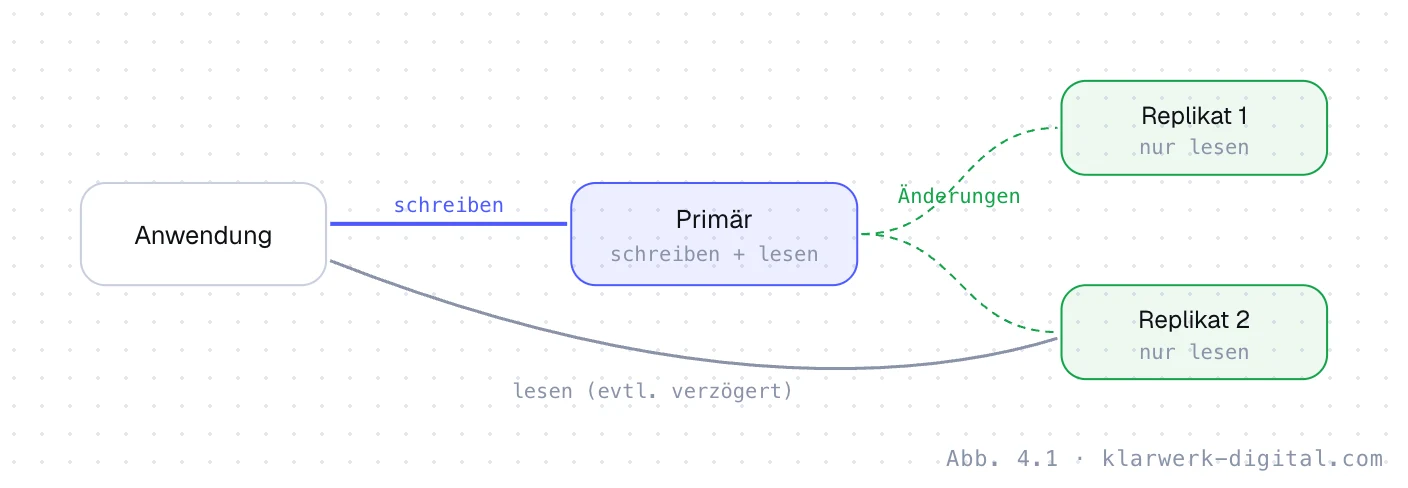
Replikation erfüllt zwei Zwecke. Erstens Ausfallsicherheit: Fällt der Primärserver aus, übernimmt ein Replikat, im besten Fall automatisch. Zweitens Leseskalierung: Weil die meisten Anwendungen viel mehr lesen als schreiben, können Leseanfragen auf die Replikate verteilt werden. Bei PostgreSQL erfolgt die Replikation über das Write-Ahead-Log, also das Protokoll aller Änderungen, das an die Replikate gestreamt wird. Verwaltete Datenbankdienste der Cloudanbieter richten das auf Knopfdruck ein.
2. Synchron oder asynchron
Bei synchroner Replikation bestätigt der Primärserver einen Schreibvorgang erst, wenn mindestens ein Replikat ihn ebenfalls gespeichert hat. Dadurch geht bei einem Ausfall nichts verloren, aber jeder Schreibvorgang wird langsamer, und fällt das Replikat aus, stockt das Schreiben. Bei asynchroner Replikation bestätigt der Primärserver sofort und überträgt die Änderung kurz danach. Das ist schneller, aber bei einem Ausfall können die letzten Änderungen verloren gehen, und Replikate hinken leicht hinterher. In der Praxis kombiniert man oft: ein synchrones Replikat für Sicherheit, weitere asynchrone für Lesezugriffe.
Die Verzögerung asynchroner Replikate, der Replication Lag, hat direkte Folgen für die Anwendung. Ein typisches Problem: Ein Nutzer ändert sein Profilbild, die Seite lädt neu, liest vom Replikat – und zeigt das alte Bild. Für den Nutzer sieht das aus wie ein Fehler. Die Lösung heißt Read-your-writes: Daten, die ein Nutzer gerade selbst geändert hat, werden für eine kurze Zeit vom Primärserver gelesen. Allgemein gilt: Lesezugriffe, die aktuelle Daten brauchen – etwa vor einer Buchung –, gehören auf den Primärserver; unkritische Lesezugriffe wie Listen und Statistiken können auf Replikate.
3. Sharding
Sharding wird nötig, wenn die Schreiblast oder die Datenmenge die Kapazität eines einzelnen Primärservers übersteigt – eine Grenze, die bei moderner Hardware sehr hoch liegt. Die wichtigste Entscheidung ist der Shard-Schlüssel. Er sollte die Daten gleichmäßig verteilen und dafür sorgen, dass die häufigsten Abfragen nur einen Shard betreffen. Probieren Sie verschiedene Schlüssel aus:
| Bereich | Problem |
|---|---|
| Abfragen über Shards | Auswertungen über alle Daten müssen alle Shards abfragen und zusammenführen |
| Transaktionen | Transaktionen über mehrere Shards sind komplex oder nicht möglich |
| Eindeutigkeit | eindeutige Regeln gelten nur innerhalb eines Shards |
| Umverteilung | neue Shards erfordern das Verschieben von Daten im laufenden Betrieb |
| Betrieb | mehr Server, mehr Backups, mehr Überwachung |
4. Partitionierung innerhalb einer Datenbank
Zwischen einer einfachen Tabelle und echtem Sharding gibt es einen Zwischenschritt: die Partitionierung innerhalb einer einzelnen Datenbank. PostgreSQL kann eine große Tabelle, etwa Ereignisse oder Protokolle, intern nach Monaten aufteilen. Für die Anwendung bleibt es eine Tabelle, aber Abfragen auf einen Monat lesen nur die passende Partition, und alte Monate lassen sich mit einem Befehl archivieren oder löschen. Das löst viele Probleme großer Tabellen ohne die Komplexität verteilter Datenbanken.
Für Anwendungen mit vielen Mandanten, etwa eine Software für Hunderte Friseursalons, gibt es zudem Erweiterungen wie Citus, die PostgreSQL um Sharding nach Mandanten erweitern, ohne dass die Anwendung grundlegend umgebaut werden muss. Und es gibt verteilte SQL-Datenbanken wie CockroachDB oder YugabyteDB, die Sharding und Replikation eingebaut haben. Sie sind mächtig, aber komplexer im Betrieb und für die meisten Anwendungen nicht nötig.
5. Eine sinnvolle Reihenfolge
Aus diesen Überlegungen ergibt sich eine bewährte Reihenfolge für wachsende Systeme. Zuerst werden Abfragen und Indizes optimiert, wie in der vorigen Lektion beschrieben. Dann wird die Hardware vergrößert – ein größerer Datenbankserver ist oft die günstigste Lösung. Häufig gelesene Daten kommen in einen Cache. Ein Replikat sorgt für Ausfallsicherheit und nimmt unkritische Lesezugriffe auf. Große, wachsende Tabellen werden partitioniert und alte Daten archiviert. Erst wenn all das nicht mehr reicht, wird über Sharding nachgedacht. Viele sehr große Anwendungen laufen jahrelang mit einem einzigen, gut optimierten Primärserver und einigen Replikaten. In der nächsten Lektion geht es um die grundsätzliche Frage, die hinter all diesen Techniken steht: Wie viel Konsistenz braucht ein System, und was kostet sie?
6. Backups sind keine Replikation
Ein verbreitetes Missverständnis lautet, Replikate machten Backups überflüssig. Das Gegenteil ist der Fall. Ein Replikat übernimmt jede Änderung des Primärservers – auch versehentlich gelöschte Tabellen, fehlerhafte Migrationen oder durch einen Angriff verschlüsselte Daten. Replikation schützt vor dem Ausfall eines Servers, nicht vor Fehlern in den Daten. Dafür braucht es Backups, und zwar solche, die einen Zustand zu einem früheren Zeitpunkt wiederherstellen können. PostgreSQL unterstützt dafür die Wiederherstellung zu einem beliebigen Zeitpunkt, indem regelmäßige Basis-Backups mit dem archivierten Änderungsprotokoll kombiniert werden.
Entscheidend ist, Backups regelmäßig tatsächlich wiederherzustellen. Ein Backup, dessen Wiederherstellung nie getestet wurde, ist eine Hoffnung, kein Plan. Ein monatlicher Test auf einer separaten Umgebung zeigt, ob die Backups vollständig sind, wie lange die Wiederherstellung dauert und ob die im ersten Modul beschriebenen Ziele für RPO und RTO eingehalten werden. Backups sollten außerdem an einem anderen Ort liegen als die Datenbank selbst, idealerweise bei einem anderen Anbieter oder in einem gesperrten Bereich, auf den ein Angreifer mit den Zugangsdaten der Anwendung nicht zugreifen kann.
Replikation, Partitionierung und Backups ergänzen sich also: Replikation für Verfügbarkeit und Leseskalierung, Partitionierung für große Tabellen, Backups für die Wiederherstellung nach Fehlern. Erst wenn diese Grundlagen stehen und tatsächlich nicht mehr reichen, lohnt der Gedanke an Sharding. Für die allermeisten Anwendungen kommt dieser Moment nie.
Wer das beherzigt, spart sich viel Komplexität. Einige der bekanntesten Webdienste der Welt laufen bis heute mit erstaunlich einfachen Datenbankarchitekturen – nicht aus Nachlässigkeit, sondern weil sie die einfacheren Mittel konsequent ausgereizt haben, bevor sie zu den schwierigeren griffen. Diese Haltung – erst das Einfache ausschöpfen, dann das Komplexe einführen – zieht sich durch den gesamten Kurs und ist einer der wichtigsten Grundsätze guter Architektur überhaupt, gerade in kleinen Teams.
- [1]PostgreSQL Global Development Group (2026): Documentation – High Availability, Load Balancing, and Replication; Table Partitioning.
- [2]Kleppmann, M. (2017): Designing Data-Intensive Applications. Sebastopol: O'Reilly, Kap. 5–6.
- [3]Corbett, J. C. et al. (2013): Spanner: Google's Globally Distributed Database. ACM Transactions on Computer Systems 31(3).
- [4]Citus Data (2026): Citus Documentation – Choosing the Distribution Column.
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.