- die Bausteine einer Anwendung mit Sprachmodell kennen
- verstehen, warum das Modell nur ein Teil des Systems ist
- das Kontextfenster als knappe Ressource planen
- Modell-Gateway, Streaming und Leitplanken im Entwurf einordnen
Wer an KI-Anwendungen denkt, denkt meist an das Sprachmodell. Doch in einer produktiven Anwendung ist das Modell nur ein Baustein unter vielen – vergleichbar mit der Datenbank in einer klassischen Web-Anwendung. Wichtig, aber allein nicht ausreichend. Um das Modell herum braucht es Komponenten, die den richtigen Kontext zusammenstellen, Werkzeuge anbinden, Antworten prüfen, Kosten begrenzen, Ausfälle abfangen und Qualität messen. Genau diese Bausteine entscheiden darüber, ob eine KI-Anwendung im Alltag zuverlässig funktioniert oder nur in der Vorführung beeindruckt. Diese Lektion gibt einen Überblick über die Architektur und legt die Grundlage für die folgenden Lektionen zu RAG, Agenten und Betrieb.
1. Das Modell ist nicht die Anwendung
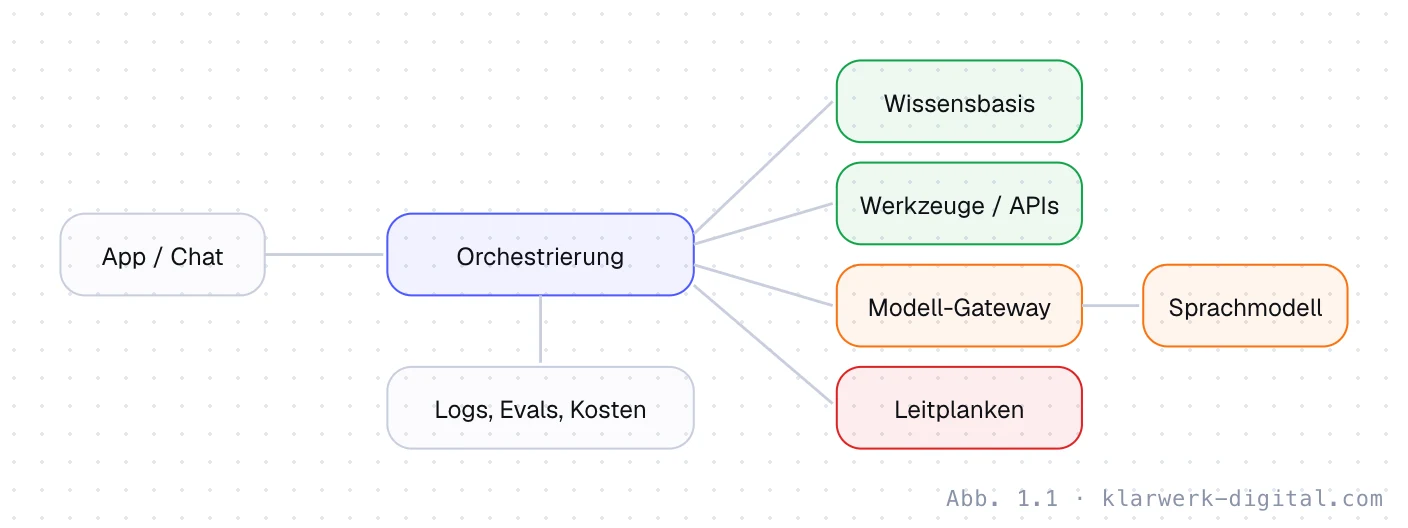
Ein Sprachmodell hat klare Eigenschaften, die den Entwurf prägen. Es ist zustandslos: Es erinnert sich an nichts, alles Nötige muss bei jeder Anfrage mitgeschickt werden. Es ist probabilistisch: Dieselbe Frage kann unterschiedliche Antworten ergeben. Es ist langsam im Vergleich zu einer Datenbankabfrage, oft Sekunden statt Millisekunden. Es ist teuer, weil jede Anfrage nach Token abgerechnet wird. Und es kann Fehler machen, die plausibel klingen. Eine gute Architektur nimmt diese Eigenschaften ernst und baut um das Modell herum die nötigen Sicherungen. Die folgende Abbildung zeigt die typischen Bausteine:
2. Die Bausteine
Erkunden Sie, welche Aufgabe jeder Baustein übernimmt:
Die Orchestrierung ist dabei ganz normaler Code. Sie lässt sich testen, versionieren und schrittweise verbessern. Wichtig ist, dass Prompts, Modellwahl und Parameter nicht verstreut im Code stehen, sondern zentral verwaltet werden, damit man sie ändern und vergleichen kann. Viele Teams behandeln Prompts inzwischen wie Konfiguration mit eigener Versionsnummer, sodass sich jede Antwort einer bestimmten Prompt-Version zuordnen lässt.
3. Das Kontextfenster als knappe Ressource
Alles, was das Modell wissen soll, muss in das Kontextfenster passen – die Menge an Text, die es bei einer Anfrage verarbeitet. Moderne Modelle haben große Kontextfenster, doch jedes Token kostet Geld und Zeit, und zu viel irrelevanter Kontext verschlechtert die Antworten sogar. Das Kontextfenster ist also eine knappe Ressource, die man bewusst plant. Stellen Sie selbst zusammen:
Die Kunst besteht darin, genau das Richtige mitzuschicken: die Systemanweisung, die wirklich nötigen Werkzeuge, die relevantesten Dokumentabschnitte und einen sinnvoll gekürzten Verlauf. Man spricht inzwischen von Context Engineering. Bewährte Techniken sind die gezielte Auswahl von Dokumenten per Suche, das Zusammenfassen älterer Gesprächsteile, das dynamische Einblenden nur der Werkzeuge, die für die aktuelle Aufgabe infrage kommen, und das Zwischenspeichern gleichbleibender Teile wie der Systemanweisung, was bei vielen Anbietern die Kosten dieser Teile deutlich senkt.
4. Das Modell-Gateway
Statt das Sprachmodell an vielen Stellen im Code direkt aufzurufen, bündelt man alle Aufrufe in einem Gateway – einer eigenen Schicht oder einem Dienst. Das bringt mehrere Vorteile. Schlüssel liegen an einer Stelle. Rate Limits und Budgets werden zentral durchgesetzt. Fällt ein Anbieter aus oder ist überlastet, kann automatisch auf ein anderes Modell ausgewichen werden. Kosten werden je Funktion, Kunde und Nutzer erfasst. Und ein Modellwechsel betrifft nur eine Stelle statt die ganze Anwendung. Gerade weil sich der Markt der Sprachmodelle schnell entwickelt, ist diese Austauschbarkeit ein wichtiges Entwurfsziel.
5. Antworten ausliefern
Weil Sprachmodelle Sekunden brauchen, ist die Auslieferung der Antwort ein eigenes Entwurfsthema. Streaming zeigt die Antwort Wort für Wort, sobald sie entsteht; die gefühlte Wartezeit sinkt drastisch, auch wenn die Gesamtdauer gleich bleibt. Technisch geschieht das meist über Server-Sent Events. Für längere Aufgaben, etwa das Auswerten eines umfangreichen Dokuments, ist eine asynchrone Verarbeitung über eine Warteschlange besser: Der Nutzer erhält sofort eine Bestätigung und wird benachrichtigt, wenn das Ergebnis fertig ist. Und für Anwendungen, die Daten weiterverarbeiten, sind strukturierte Ausgaben wichtig: Das Modell liefert kein freies Textstück, sondern ein JSON-Objekt nach festem Schema, das der Code zuverlässig verarbeiten kann.
| Anwendungsfall | Auslieferung |
|---|---|
| Chat mit Kundenservice-Assistent | Streaming, Antwort erscheint sofort |
| Zusammenfassung eines 80-seitigen Vertrags | asynchron mit Statusanzeige |
| Kategorisierung eingehender E-Mails | strukturierte Ausgabe, im Hintergrund |
| Produkttexte für 2.000 Artikel | Stapelverarbeitung, oft günstiger |
6. Leitplanken
Leitplanken sind Prüfungen vor und nach dem Modellaufruf. Vor dem Aufruf werden Eingaben geprüft: Enthält die Anfrage personenbezogene Daten, die nicht an einen externen Anbieter gehen sollen? Versucht jemand, das Modell mit eingeschleusten Anweisungen zu manipulieren? Nach dem Aufruf wird die Ausgabe geprüft: Hat sie das erwartete Format? Enthält sie unzulässige Aussagen, etwa Heilversprechen oder Rechtsberatung? Stützt sie sich auf die gelieferten Quellen? Je nach Risiko kommt eine Freigabe durch Menschen hinzu. Eine Antwort auf die Frage nach den Öffnungszeiten eines Cafés braucht keine Freigabe; ein automatisch erstelltes Angebot über mehrere tausend Euro schon.
7. Ein Beispiel
Ein Fahrradladen möchte auf seiner Website einen Assistenten anbieten, der Fragen zu E-Bikes, Wartung und Terminen beantwortet. Der Entwurf sieht vor: Die Oberfläche streamt Antworten und zeigt Quellen. Die Orchestrierung holt passende Abschnitte aus Handbüchern und FAQ, fügt die aktuellen Öffnungszeiten ein und bietet zwei Werkzeuge an: freie Werkstatttermine suchen und einen Termin reservieren. Die Reservierung verlangt eine ausdrückliche Bestätigung des Kunden. Alle Modellaufrufe laufen über ein Gateway mit Tagesbudget und automatischem Wechsel auf ein zweites Modell bei Störungen. Leitplanken verhindern Aussagen zu Garantie- oder Haftungsfragen und verweisen dann an das Team. Jede Unterhaltung wird ohne personenbezogene Daten protokolliert, sodass das Team wöchentlich prüfen kann, wo der Assistent danebenlag. So entsteht aus einem Sprachmodell eine Anwendung, die dem Laden wirklich Arbeit abnimmt und der die Kundschaft vertrauen kann.
Die nächsten Lektionen vertiefen die wichtigsten Bausteine: wie man Wissen zuverlässig bereitstellt, wie Agenten mehrere Schritte selbstständig planen und ausführen, und wie man Kosten, Geschwindigkeit und Qualität im Betrieb misst und steuert.
Wer eine solche Anwendung plant, sollte früh drei Fragen beantworten. Erstens: Welche Aufgabe übernimmt das Modell genau, und was erledigt besser normaler Code? Rechnen, Datenbankabfragen und feste Regeln gehören in den Code, Formulieren, Zusammenfassen und Einordnen unklarer Eingaben zum Modell. Zweitens: Was passiert, wenn das Modell falsch liegt oder nicht erreichbar ist? Drittens: Woran erkennen wir, dass die Anwendung gut funktioniert? Wer diese Fragen beantwortet hat, hat den Kern des Entwurfs bereits geklärt.
- [1]Huyen, C. (2025): AI Engineering – Building Applications with Foundation Models. Sebastopol: O'Reilly.
- [2]Anthropic (2026): Building with Claude – Prompt Caching, Tool Use, Streaming. docs.anthropic.com.
- [3]OWASP Foundation (2025): OWASP Top 10 for Large Language Model Applications.
- [4]Bommasani, R. et al. (2021): On the Opportunities and Risks of Foundation Models. Stanford CRFM.
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.