- die Ebenen des Cachings vom Browser bis zur Datenbank kennen
- Cache-Aside, Write-Through und weitere Muster unterscheiden
- Invalidierung und Lebensdauer bewusst planen
- typische Probleme wie veraltete Daten und Cache Stampede vermeiden
Caching ist die wirksamste und zugleich gefährlichste Optimierung im System Design. Wirksam, weil ein Zugriff auf den Arbeitsspeicher um Größenordnungen schneller ist als eine Datenbankabfrage oder ein Aufruf eines externen Dienstes. Gefährlich, weil jeder Cache eine Kopie ist, die veralten kann. Phil Karlton wird der Satz zugeschrieben, es gebe nur zwei schwierige Dinge in der Informatik: Cache-Invalidierung und die Benennung von Dingen. Diese Lektion zeigt, wie man Caches so einsetzt, dass sie viel bringen und wenig Schaden anrichten.
1. Ebenen des Cachings
| Ebene | Beispiel | Steuerung |
|---|---|---|
| Browser | Bilder, Skripte, API-Antworten | HTTP-Header Cache-Control, ETag |
| CDN | statische Dateien, öffentliche Seiten | Cache-Control, Regeln im CDN |
| Anwendung (lokal) | Konfiguration im Arbeitsspeicher | Code, kurze Lebensdauer |
| Verteilter Cache | Redis mit Ergebnissen, Sitzungen | Schlüssel, TTL, Invalidierung |
| Datenbank | Puffer für häufig gelesene Seiten | automatisch, Speicherzuteilung |
Jede Ebene hat ihren Zweck. Der Browser-Cache spart Netzwerkverkehr ganz, das CDN entlastet den Server und verkürzt Wege, der verteilte Cache entlastet die Datenbank. Die Faustregel lautet: so nah wie möglich am Nutzer cachen, was für alle gleich ist, und personalisierte Daten nur dort, wo sie sicher getrennt sind.
2. Was ein Cache bringt
Der Nutzen eines Caches hängt vor allem von der Trefferquote ab: dem Anteil der Anfragen, die direkt aus dem Cache beantwortet werden können. Probieren Sie aus, wie sich Trefferquote und Lebensdauer auswirken:
100/s
Datenbanklast
5,8 ms
Ø Lesezeit
max. 1 min veraltet
Preis der Geschwindigkeit
Schon eine Trefferquote von 80 Prozent entlastet die Datenbank um den Faktor fünf. Bei 95 Prozent ist es der Faktor zwanzig. Deshalb lohnen sich Caches besonders für Daten, die oft gelesen und selten geändert werden: Produktseiten, Kursübersichten, Konfigurationen, Ergebnisse teurer Berechnungen. Weniger lohnend sind sie für Daten, die sich ständig ändern oder für jeden Nutzer anders sind.
3. Muster
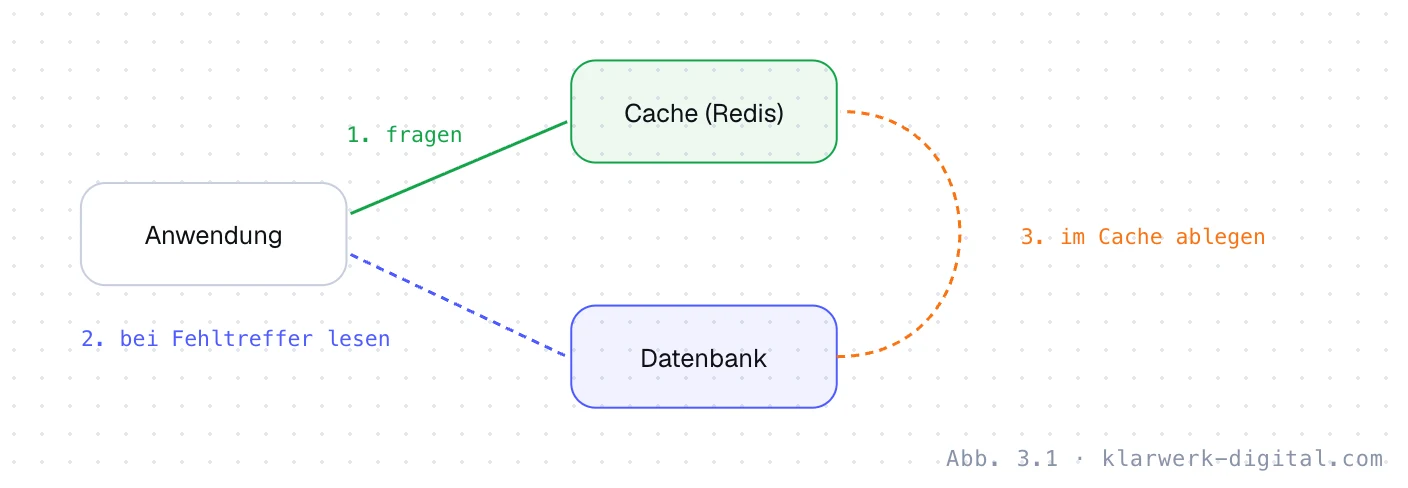
Neben Cache-Aside gibt es weitere Muster. Bei Write-Through schreibt die Anwendung Änderungen gleichzeitig in Datenbank und Cache, sodass der Cache immer aktuell ist, aber jeder Schreibvorgang langsamer wird. Bei Write-Behind wird zuerst in den Cache geschrieben und später gesammelt in die Datenbank – schnell, aber mit dem Risiko, Daten bei einem Ausfall zu verlieren. Und beim Vorwärmen werden wichtige Einträge vorab in den Cache geladen, etwa nach einem Deployment. Für die meisten Anwendungen ist Cache-Aside mit einer sinnvollen Lebensdauer und gezielter Invalidierung die beste Wahl.
4. Invalidierung
Die schwierigste Frage beim Caching lautet: Wann ist ein Eintrag veraltet? Zwei Ansätze ergänzen sich. Die Lebensdauer (TTL) legt fest, dass ein Eintrag nach einer bestimmten Zeit automatisch verfällt. Das ist einfach und robust, bedeutet aber, dass Daten bis zu dieser Zeit veraltet sein können. Die gezielte Invalidierung löscht einen Eintrag, sobald sich die zugrunde liegenden Daten ändern. Das hält den Cache aktuell, erfordert aber, dass jede Änderung an allen betroffenen Stellen berücksichtigt wird – und vergessene Stellen führen zu schwer auffindbaren Fehlern.
In der Praxis kombiniert man beides: eine moderate Lebensdauer als Sicherheitsnetz und gezielte Invalidierung für wichtige Änderungen. Eine elegante Variante sind versionierte Schlüssel. Statt einen Eintrag zu löschen, erhöht man eine Versionsnummer, die Teil des Schlüssels ist; alte Einträge werden nicht mehr gefunden und verfallen von selbst. Für kritische Daten gilt die Regel aus dem Modul zur Datenhaltung: Was an Invarianten, Geld oder Berechtigungen hängt, wird bei entscheidenden Vorgängen nicht aus dem Cache, sondern aus der Quelle gelesen.
5. Typische Probleme
Einige Probleme treten beim Caching immer wieder auf. Eine Cache Stampede entsteht, wenn ein häufig gelesener Eintrag abläuft und in diesem Moment Hunderte Anfragen gleichzeitig die Datenbank abfragen, um ihn neu zu berechnen. Abhilfe schaffen Sperren, sodass nur eine Anfrage neu berechnet, und leicht zufällige Lebensdauern, damit nicht alle Einträge gleichzeitig ablaufen. Personalisierte Daten im gemeinsamen Cache sind ein Sicherheitsproblem: Wird eine Seite mit den Daten eines Nutzers unter einem allgemeinen Schlüssel gespeichert, sehen andere Nutzer fremde Daten. Schlüssel für personalisierte Daten müssen deshalb immer die Nutzer- oder Mandanten-ID enthalten, und CDNs dürfen solche Antworten nicht speichern.
| Problem | Gegenmaßnahme |
|---|---|
| veraltete Daten | passende TTL, gezielte Invalidierung, kritische Prüfung gegen die Quelle |
| Cache Stampede | Sperre beim Neuberechnen, zufällige TTL-Abweichung |
| fremde Daten sichtbar | Nutzer-ID im Schlüssel, Cache-Control: private |
| Cache voll | Verdrängungsstrategie (LRU), Speicherlimit, nur Nützliches cachen |
| Ausfall des Caches | Anwendung funktioniert ohne Cache weiter, nur langsamer |
6. Caching im Entwurf
Im Systementwurf sollte Caching nicht der erste, sondern ein gezielter Schritt sein. Zuerst werden Abfragen und Indizes optimiert, dann wird gemessen, welche Leseanfragen die meiste Last erzeugen. Für genau diese wird ein Cache eingeführt, mit bewusst gewählter Lebensdauer und dokumentierter Invalidierung. Die Trefferquote wird überwacht; sinkt sie, stimmt etwas mit den Schlüsseln oder der Lebensdauer nicht. Und die Anwendung wird so gebaut, dass sie auch ohne Cache funktioniert. So bleibt der Cache eine Beschleunigung, keine Abhängigkeit, und seine Vorteile überwiegen deutlich die Risiken, die jede zusätzliche Kopie von Daten mit sich bringt.
7. Ein Beispiel aus der Praxis
Ein Online-Café mit eigener Kaffeerösterei verkauft Bohnen über einen Webshop. Die Produktseiten werden bei jedem Aufruf aus der Datenbank zusammengesetzt, samt Bewertungen, Lagerbestand und Preisen. Als ein bekannter Kochkanal eine Sorte empfiehlt, steigt die Last innerhalb von Minuten auf das Zwanzigfache, und die Datenbank wird zum Engpass. Die Lösung besteht aus drei Stufen. Erstens werden die öffentlichen Produktseiten ohne Warenkorbinformationen für eine Minute im CDN gecacht; damit erreichen neunzig Prozent der Aufrufe den Server gar nicht mehr. Zweitens werden die Bewertungen, die sich selten ändern, für zehn Minuten in Redis gehalten und bei einer neuen Bewertung gezielt gelöscht. Drittens wird der Lagerbestand bewusst nicht gecacht, sondern beim Hinzufügen zum Warenkorb und beim Bezahlen immer frisch aus der Datenbank geprüft.
Das Ergebnis: Die Seite bleibt auch bei Spitzenlast schnell, und niemand kauft eine ausverkaufte Sorte, weil die entscheidende Prüfung gegen die Quelle erfolgt. Die Anzeige „nur noch drei auf Lager“ darf dabei ruhig eine Minute alt sein. Dieses Beispiel zeigt das Grundprinzip gutes Cachings: für jede Information einzeln entscheiden, wie aktuell sie sein muss, und die Lebensdauer entsprechend wählen, statt pauschal alles oder nichts zu cachen.
Zusammengefasst: Cachen Sie gezielt das, was oft gelesen und selten geändert wird, wählen Sie die Lebensdauer passend zur fachlichen Anforderung, und behalten Sie die Trefferquote im Blick. Dann ist ein Cache eine der günstigsten Möglichkeiten, ein System spürbar schneller zu machen. Und wenn doch einmal veraltete Daten auftauchen, hilft eine dokumentierte Übersicht aller Caches mit Schlüsseln, Lebensdauer und Invalidierung, die Ursache schnell zu finden.
- [1]Redis Ltd. (2026): Redis Documentation – Caching Patterns; Key Eviction.
- [2]IETF RFC 9111 (2022): HTTP Caching.
- [3]Nishtala, R. et al. (2013): Scaling Memcache at Facebook. Proceedings of USENIX NSDI, 385–398.
- [4]Kleppmann, M. (2017): Designing Data-Intensive Applications. Sebastopol: O'Reilly, Kap. 11–12.
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.