- den Unterschied zwischen Warteschlange und Event-Log verstehen
- Topics, Partitionen, Offsets und Consumer-Gruppen erklären
- Reihenfolge, Replay und Schemaentwicklung einordnen
- Event Streaming bewusst einsetzen – und erkennen, wann es zu viel ist
In der vorigen Lektion ging es um Warteschlangen: Aufträge werden hineingelegt, von einem Worker erledigt und verschwinden dann. Event Streaming folgt einem anderen Gedanken. Hier werden Ereignisse – Dinge, die passiert sind – dauerhaft in einem geordneten Log gespeichert. Beliebig viele Dienste können dieses Log lesen, jeder in seinem eigenen Tempo, und jeder kann bei Bedarf von vorn beginnen. Bekannte Systeme sind Apache Kafka, Redpanda, Amazon Kinesis oder Redis Streams. Event Streaming ist mächtig, aber auch anspruchsvoll, und es lohnt sich zu verstehen, wann es wirklich passt.
1. Ereignisse statt Aufträge
Der Unterschied klingt klein, verändert aber die Architektur. Ein Auftrag wie „sende Bestätigungs-E-Mail“ richtet sich an genau einen Empfänger. Ein Ereignis wie „Buchung angelegt“ kann dagegen viele interessieren: den E-Mail-Dienst, die Statistik, den Suchindex, die Abrechnung. Der Dienst, der die Buchung anlegt, muss keinen von ihnen kennen. Er veröffentlicht nur das Ereignis. Neue Interessenten können später hinzukommen, ohne dass der ursprüngliche Dienst geändert werden muss. Diese lose Kopplung ist der größte Vorteil ereignisgetriebener Systeme.
2. Das Log
Im Kern ist ein Event-Stream ein Log, an das nur angehängt wird. Jedes Ereignis bekommt eine fortlaufende Position, den Offset. Konsumenten lesen das Log der Reihe nach und merken sich, bis wohin sie gelesen haben. Anders als bei einer Warteschlange wird ein Ereignis beim Lesen nicht entfernt; es bleibt für eine festgelegte Zeit oder dauerhaft erhalten. Probieren Sie aus, wie drei Dienste dasselbe Log unabhängig lesen:
Offset 0
BuchungAngelegt #101
Offset 1
ZahlungEingegangen #101
Offset 2
BuchungAngelegt #102
Offset 3
BuchungStorniert #101
Offset 4
BuchungAngelegt #103
Offset 5
ZahlungEingegangen #103
Offset 6
BuchungAngelegt #104
Offset 7
ZahlungEingegangen #102
Das eröffnet Möglichkeiten, die eine Warteschlange nicht bietet. Ein Dienst, der eine Stunde ausgefallen war, liest nach dem Neustart einfach dort weiter, wo er aufgehört hat. Ein neuer Dienst kann die gesamte Geschichte nachlesen und daraus seinen eigenen Datenbestand aufbauen. Und wenn ein Fehler in der Verarbeitung entdeckt wird, kann man ihn beheben und die betroffenen Ereignisse erneut verarbeiten – das sogenannte Replay.
3. Topics, Partitionen und Consumer-Gruppen
Ereignisse werden in Topics organisiert, etwa „buchungen“ oder „zahlungen“. Damit ein Topic sehr viele Ereignisse verarbeiten kann, wird es in Partitionen aufgeteilt, die auf verschiedenen Servern liegen und parallel gelesen werden können. Innerhalb einer Partition ist die Reihenfolge garantiert, über Partitionen hinweg nicht. Deshalb wählt man einen Partitionsschlüssel, der zusammengehörende Ereignisse in dieselbe Partition bringt – etwa die Buchungsnummer, damit „angelegt“, „bezahlt“ und „storniert“ derselben Buchung in der richtigen Reihenfolge ankommen.
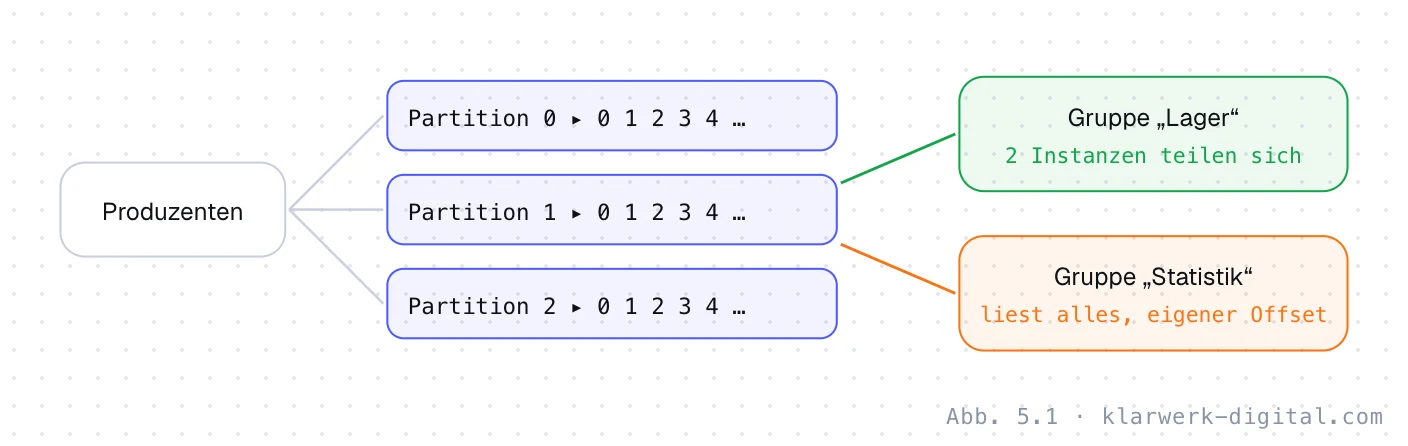
Konsumenten sind in Consumer-Gruppen organisiert. Jede Gruppe erhält alle Ereignisse, und innerhalb einer Gruppe werden die Partitionen auf die Instanzen verteilt. Hat ein Topic sechs Partitionen, können bis zu sechs Instanzen einer Gruppe parallel arbeiten. Die Zahl der Partitionen begrenzt also die Parallelität und sollte bei der Planung bedacht werden.
4. Warteschlange oder Stream?
Beide Techniken haben ihren Platz. Üben Sie die Zuordnung:
Ein PDF pro Rechnung erzeugen – jede Rechnung genau einmal von irgendeinem Worker
Jede Bestellung soll Lager, Buchhaltung und Empfehlungssystem unabhängig erreichen
Ein neuer Analysedienst soll die Ereignisse der letzten drei Monate nachverarbeiten
Passwort-Zurücksetzen-E-Mails verschicken
Klickdaten von Millionen Nutzern sammeln und in Echtzeit auswerten
| Kriterium | Warteschlange | Event Stream |
|---|---|---|
| Inhalt | Aufträge | Ereignisse (Tatsachen) |
| Nach dem Lesen | entfernt | bleibt erhalten |
| Empfänger | ein Worker pro Auftrag | jede Gruppe liest alles |
| Replay | nicht vorgesehen | jederzeit möglich |
| Reihenfolge | meist ohne Garantie | pro Partition garantiert |
| Betriebsaufwand | gering | deutlich höher |
5. Herausforderungen
Event Streaming bringt eigene Schwierigkeiten mit sich. Die erste ist die Schemaentwicklung: Ereignisse bleiben lange gespeichert, und Konsumenten verlassen sich auf ihr Format. Ändert man ein Feld, brechen möglicherweise Dienste, die man gar nicht kennt. Deshalb werden Ereignisschemata versioniert und nur abwärtskompatibel erweitert, oft mit einer Schema-Registry. Die zweite ist die doppelte Verarbeitung: Auch hier gilt meist „mindestens einmal“, und Konsumenten müssen idempotent sein. Die dritte ist das Dual-Write-Problem: Wenn ein Dienst erst in die Datenbank schreibt und dann ein Ereignis veröffentlicht, kann dazwischen etwas schiefgehen. Das Outbox-Muster löst das, indem das Ereignis in derselben Transaktion in eine Tabelle geschrieben und von dort zuverlässig veröffentlicht wird.
6. Wann es sich lohnt
Event Streaming ist ein Werkzeug für bestimmte Situationen: sehr hohe Datenmengen, viele unabhängige Konsumenten, der Bedarf nach Replay und Geschichte oder die Integration vieler Teams und Systeme. Ein großer Onlinehändler, eine Mobilitätsplattform oder ein Zahlungsdienstleister profitieren davon. Für eine typische Web-Anwendung eines kleinen Teams ist ein eigener Kafka-Cluster dagegen meist zu viel. Eine Warteschlange, eine Outbox-Tabelle in PostgreSQL und eine Handvoll Worker decken die meisten Anforderungen ab und sind viel einfacher zu betreiben. Wer später wächst, kann auf Event Streaming umsteigen – die Denkweise in Ereignissen lässt sich aber schon früh übernehmen und erleichtert diesen Schritt erheblich.
Ein Beispiel: Eine Fahrradvermietung mit hundert Stationen startet mit einer Datenbank und einer Warteschlange für Benachrichtigungen. Als Jahre später Stationen, App, Buchhaltung, Wartungsplanung und ein Prognosemodell für Nachfrage dieselben Ausleihen verarbeiten sollen, wird ein Event Stream eingeführt. Weil die Anwendung schon von Anfang an klare Ereignisse wie „Ausleihe begonnen“ und „Rad zurückgegeben“ in einer Outbox festgehalten hat, ist der Umstieg überschaubar, und das Prognosemodell kann direkt mit der gesamten Geschichte trainiert werden.
7. Gute Ereignisse entwerfen
Wie ein gutes Ereignis aussieht, ist eine eigene Entwurfsfrage. Ein Ereignis braucht eine eindeutige Kennung, damit Konsumenten Duplikate erkennen, einen Zeitstempel, den Typ und eine Schemaversion sowie die fachlichen Daten. Umstritten ist, wie viele Daten ein Ereignis enthalten sollte. Schlanke Ereignisse enthalten nur die Kennung, etwa „Buchung 4711 angelegt“, und Konsumenten holen sich die Details bei Bedarf. Das hält Ereignisse klein, erzeugt aber zusätzliche Abfragen und kann zu Widersprüchen führen, wenn sich die Buchung inzwischen geändert hat. Vollständige Ereignisse enthalten alle relevanten Daten zum Zeitpunkt des Geschehens. Sie sind größer, aber Konsumenten sind unabhängig, und ein Replay liefert genau den damaligen Zustand.
Datenschutz verdient bei Ereignissen besondere Aufmerksamkeit. Weil Logs lange aufbewahrt und von vielen Diensten gelesen werden, sollten personenbezogene Daten sparsam enthalten sein. Das Recht auf Löschung ist in einem unveränderlichen Log schwierig umzusetzen; bewährte Ansätze sind, nur Kennungen statt Namen und Adressen zu speichern oder personenbezogene Felder zu verschlüsseln und bei einer Löschung den Schlüssel zu vernichten. Solche Entscheidungen sollten früh getroffen werden, denn nachträglich lassen sie sich in einem gewachsenen Log nur mit großem Aufwand ändern.
Der Merksatz für die Praxis lautet: in Ereignissen denken, aber einfache Werkzeuge nutzen, solange sie genügen. Ein eigener Event-Stream-Cluster ist erst dann gerechtfertigt, wenn Datenmenge, Zahl der Konsumenten oder der Bedarf an Replay es wirklich verlangen.
- [1]Kreps, J. (2013): The Log – What every software engineer should know about real-time data's unifying abstraction. LinkedIn Engineering.
- [2]Apache Software Foundation (2026): Apache Kafka Documentation – Design; Consumer Groups.
- [3]Kleppmann, M. (2017): Designing Data-Intensive Applications. Sebastopol: O'Reilly, Kap. 11.
- [4]Richardson, C. (2018): Microservices Patterns. Shelter Island: Manning (Transactional Outbox).
Stand: September 2026. Kursmaterial der Klarwerk Akademie. Zahlen zu Latenzen und Kosten sind Größenordnungen zur Orientierung, keine Messwerte.