- die Dimensionen der Datenqualität benennen
- erklären, warum mehr Daten nicht automatisch bessere Modelle bedeuten
- typische Formen von Verzerrung (Bias) erkennen
- Maßnahmen für bessere Trainingsdaten ableiten
Ein Modell kann nur so gut sein wie die Daten, aus denen es lernt. In der Informatik heißt dieser Grundsatz Garbage in, garbage out. Diese Lektion zeigt, woran man gute Daten erkennt und wie Verzerrungen entstehen – eine der wichtigsten Fragen für den verantwortungsvollen Einsatz von KI.
1. Was gute Daten ausmacht
| Dimension | Leitfrage | Beispiel für ein Problem |
|---|---|---|
| Vollständigkeit | Fehlen Werte oder ganze Fälle? | Bei 30 % der Aufträge fehlt die Branche. |
| Korrektheit | Stimmen die Werte? | Vertipper bei Beträgen, falsche Zuordnungen. |
| Aktualität | Bilden die Daten die heutige Lage ab? | Preise von 2019 für ein Preismodell 2026. |
| Konsistenz | Sind Formate und Bedeutungen einheitlich? | „Hamburg“, „HH“ und „Hambrg“ als drei Städte. |
| Repräsentativität | Spiegeln die Daten die Einsatzwirklichkeit? | Kundendaten fast nur aus einer Region. |
| Label-Qualität | Sind die richtigen Antworten wirklich richtig? | Uneinheitliche Einordnung durch verschiedene Bearbeiter. |
2. Menge oder Qualität?
Große Datenmengen haben den Fortschritt der letzten Jahre ermöglicht. Für die meisten Unternehmensanwendungen gilt aber: Tausend saubere, passende Beispiele schlagen eine Million unpassende. Mehr Daten helfen nur, wenn sie die Aufgabe tatsächlich abbilden. Fehler in großen Datenmengen werden nicht herausgemittelt, wenn sie systematisch sind – sie werden mitgelernt.
3. Verzerrung (Bias)
| Form | Entstehung | Folge |
|---|---|---|
| Stichprobenverzerrung | Die Daten stammen überwiegend aus einer Teilgruppe. | Das Modell funktioniert für andere Gruppen schlechter. |
| Historische Verzerrung | Die Daten spiegeln frühere, unfaire Entscheidungen. | Das Modell setzt alte Muster fort. |
| Messverzerrung | Merkmale werden je nach Gruppe unterschiedlich erfasst. | Unterschiede entstehen durch die Erfassung, nicht durch die Sache. |
| Label-Verzerrung | Menschliche Einordnungen sind uneinheitlich oder voreingenommen. | Das Modell übernimmt die Vorurteile der Bewertenden. |
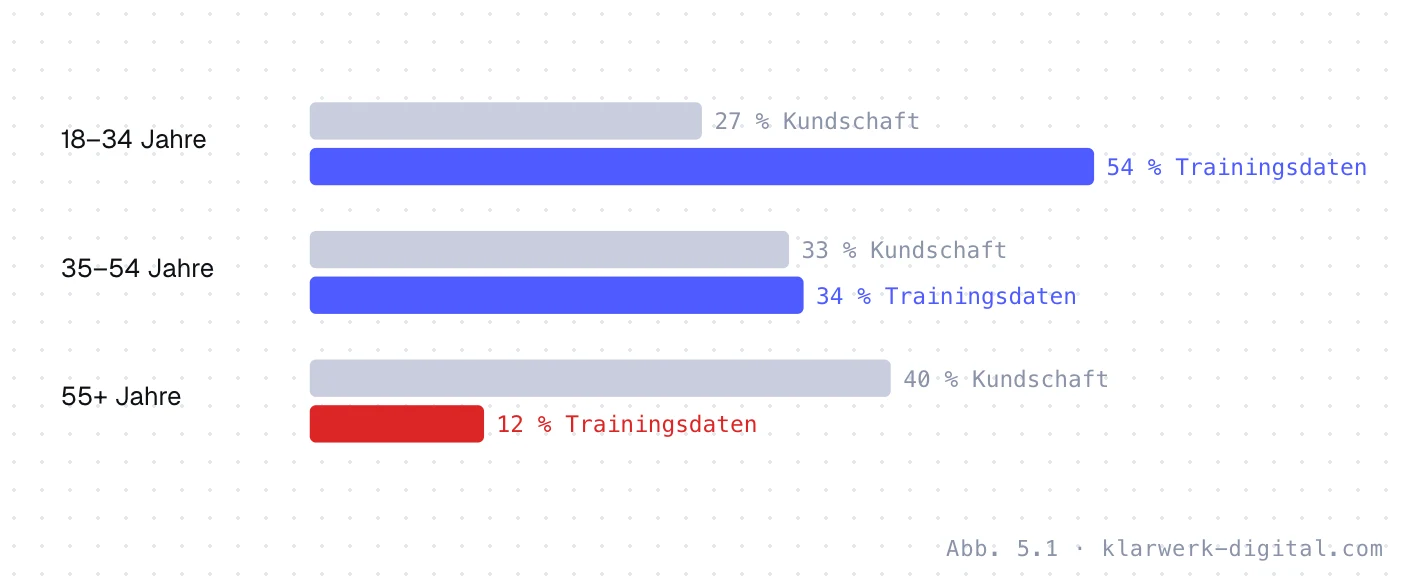
Wie ernst die Folgen sein können, zeigt ein viel zitiertes Beispiel: 2018 wurde bekannt, dass ein großer Onlinehändler ein experimentelles Werkzeug zur Bewerberauswahl eingestellt hatte. Es war mit Bewerbungen aus zehn Jahren trainiert worden, die überwiegend von Männern stammten, und bewertete Bewerbungen von Frauen systematisch schlechter.
4. Was hilft
- Daten dokumentieren: Herkunft, Zeitraum, Zusammensetzung und bekannte Lücken festhalten – etwa in Form eines Datenblatts.
- Getrennt auswerten: Die Genauigkeit nicht nur insgesamt, sondern für relevante Gruppen einzeln messen.
- Gezielt ergänzen: Unterrepräsentierte Fälle nachsammeln statt einfach mehr vom Gleichen.
- Menschen einbeziehen: Wo Entscheidungen Menschen betreffen, bleibt eine menschliche Prüfung unverzichtbar.
Übung
- Ein Modell zur Schadensprüfung wurde nur mit Fällen aus Süddeutschland trainiert. Welche Qualitätsdimension ist betroffen?
- Warum lösen „einfach mehr Daten“ eine historische Verzerrung nicht?
Lösungshinweise
- Repräsentativität – es liegt eine Stichprobenverzerrung vor.
- Weil zusätzliche Daten aus derselben Quelle dieselben früheren Entscheidungsmuster enthalten. Die Verzerrung wird dadurch eher verstärkt als ausgeglichen.
- [1]Mehrabi, N. et al. (2021): A Survey on Bias and Fairness in Machine Learning. ACM Computing Surveys, 54(6).
- [2]Gebru, T. et al. (2021): Datasheets for Datasets. Communications of the ACM, 64(12).
- [3]Dastin, J. (2018): Amazon scraps secret AI recruiting tool that showed bias against women. Reuters, 10.10.2018.
- [4]Verordnung (EU) 2024/1689 (KI-Verordnung), Art. 10 Daten und Daten-Governance.
Stand: September 2026. Kursmaterial der Klarwerk Akademie – Abbildungen sind vereinfachte, schematische Darstellungen.