Lernziele
- Halluzinationen definieren und ihre technischen Ursachen erklären
- weitere systematische Grenzen von Sprachmodellen kennen
- Gegenmaßnahmen auf mehreren Ebenen zuordnen
- die Zuverlässigkeit einer KI-Anwendung realistisch einschätzen
Sprachmodelle sind leistungsfähig – und machen dennoch Fehler, die für Menschen ungewohnt sind: Sie erfinden Quellen, verrechnen sich bei einfachen Aufgaben oder widersprechen sich. Wer die Ursachen kennt, kann diese Grenzen gezielt abfangen.
1. Was eine Halluzination ist
Definition 6.1
Halluzination
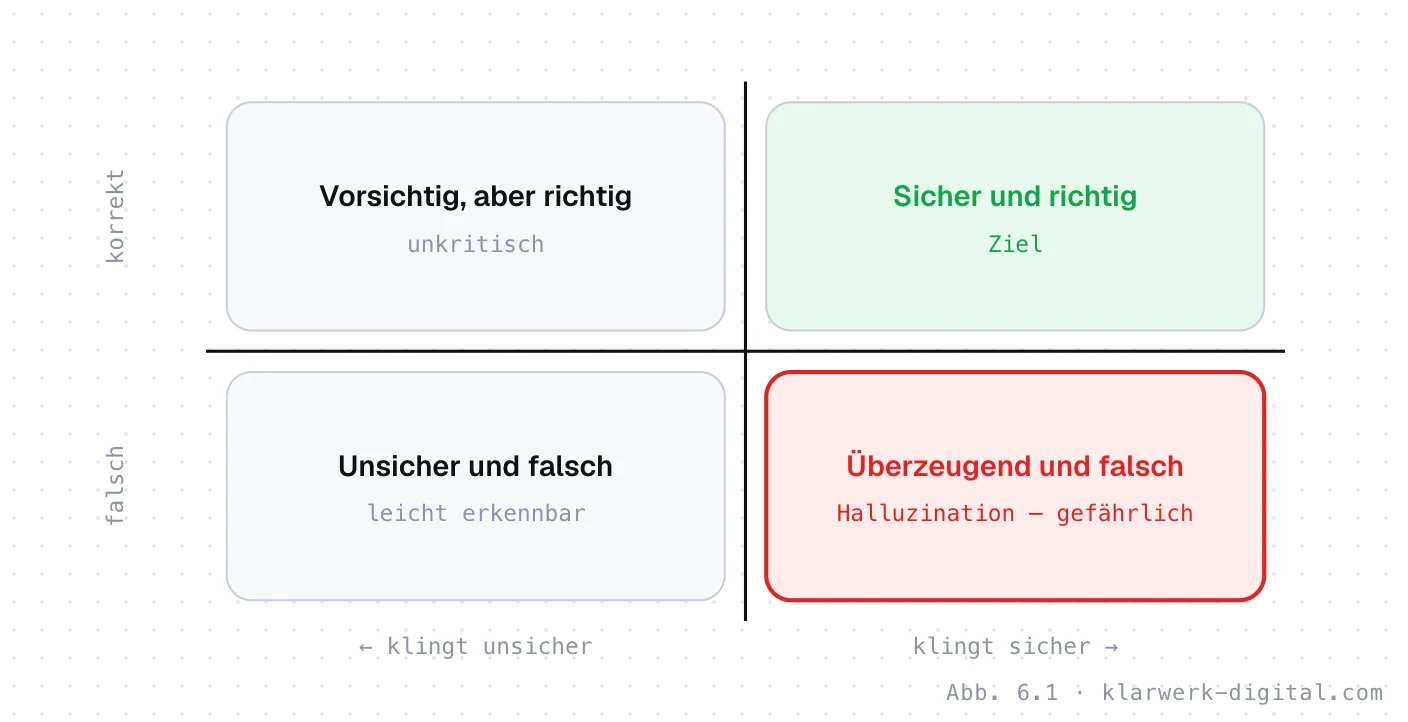
Eine vom Modell erzeugte Aussage, die sprachlich plausibel ist, aber nicht durch die Eingabe oder die Wirklichkeit gedeckt ist – etwa ein erfundenes Zitat, eine nicht existierende Studie oder eine falsche Zahl.
Abb. 6.1Warum Halluzinationen gefährlich sind
2. Die technischen Ursachen
| Ursache | Erklärung |
|---|---|
| Trainingsziel | Das Modell wird darauf trainiert, wahrscheinliche Fortsetzungen zu erzeugen – nicht darauf, Wahrheit zu prüfen. |
| Kein Faktenspeicher | Wissen liegt verteilt in Milliarden Parametern vor, nicht als nachschlagbare Einträge. |
| Lücken und Wissensstand | Zu seltenen oder neuen Themen fehlen Trainingsdaten – das Modell füllt die Lücke mit Plausiblem. |
| Druck zur Antwort | Modelle sind darauf trainiert, hilfreich zu antworten, und geben Unsicherheit oft nicht von sich aus zu. |
| Fehlerfortpflanzung | Ein früh erzeugter Fehler wird Teil des Kontexts und in den folgenden Tokens weitergeführt. |
3. Weitere systematische Grenzen
- Rechnen und Zählen: Durch die Verarbeitung in Tokens fallen exakte Rechen- und Zählaufgaben schwer – Werkzeuge wie ein Taschenrechner lösen das zuverlässig.
- Kontextfenster: Sehr lange Dokumente werden nur teilweise oder ungleichmäßig berücksichtigt.
- Nicht deterministisch: Dieselbe Frage kann unterschiedliche Antworten erzeugen.
- Korrelation statt Kausalität: Modelle geben statistische Zusammenhänge wieder, ohne Ursache und Wirkung sicher zu unterscheiden.
- Manipulierbarkeit: Versteckte Anweisungen in Texten – sogenannte Prompt Injection – können das Verhalten verändern.
4. Gegenmaßnahmen auf mehreren Ebenen
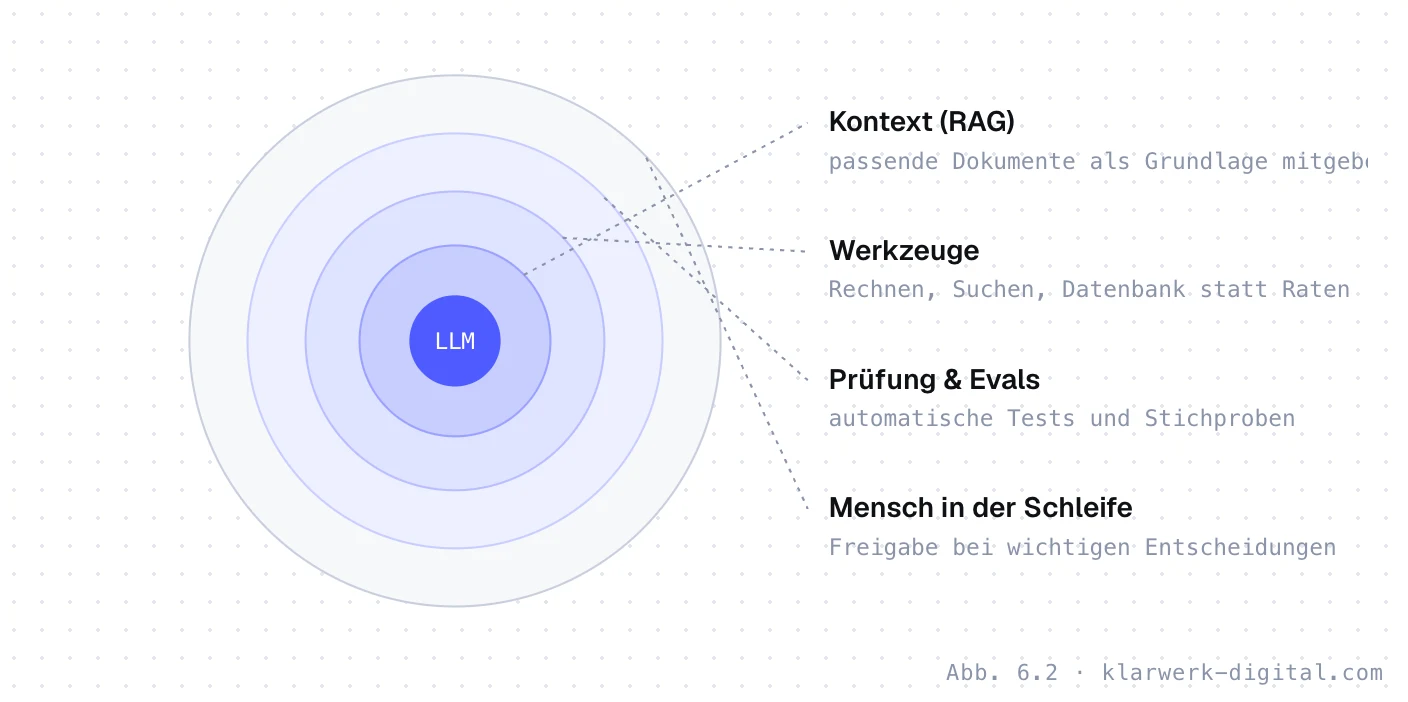
Keine einzelne Maßnahme beseitigt Halluzinationen vollständig. Zuverlässige Anwendungen kombinieren deshalb mehrere Schutzschichten:
Abb. 6.2Schutzschichten um ein Sprachmodell
Wie man diese Schichten in eigenen Anwendungen umsetzt – mit Tests, Evals und klaren Leitplanken –, lernen Sie im Modul Harness Engineering des Kurses Full Stack mit KI. Einen praxisnahen Einstieg gibt auch der Beitrag Vibe Coding.
Die entscheidende Frage lautet nicht „Halluziniert das Modell?“ – das tut jedes. Sondern: Wie hoch ist der Schaden, wenn es passiert, und welche Schicht fängt es ab?
Übung
- Ein Chatbot soll Kunden die aktuellen Lieferzeiten nennen. Welche Schutzschicht verhindert am wirksamsten erfundene Angaben?
- Warum ist eine selbstbewusst formulierte falsche Antwort problematischer als eine unsichere?
Lösungshinweise
- Kontext bzw. Werkzeuge: Die Lieferzeiten sollten aus einer Datenbank oder einem angebundenen System kommen, statt vom Modell „erinnert“ zu werden.
- Weil Menschen sie seltener hinterfragen – der Fehler wird übernommen, statt geprüft.
Quellen und weiterführende Literatur
- [1]Ji, Z. et al. (2023): Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, 55(12).
- [2]Lewis, P. et al. (2020): Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS.
- [3]Greshake, K. et al. (2023): Not What You’ve Signed Up For – Compromising Real-World LLM-Integrated Applications with Indirect Prompt Injection. ACM AISec Workshop.
Stand: September 2026. Kursmaterial der Klarwerk Akademie – Abbildungen sind vereinfachte, schematische Darstellungen.