- erklären, wie ein Sprachmodell Text in Tokens und Vektoren übersetzt
- das Prinzip der Aufmerksamkeit (Attention) im Transformer verstehen
- die Trainingsphasen Vortraining und Feinabstimmung unterscheiden
- Kontextfenster und Temperatur einordnen
Große Sprachmodelle – englisch Large Language Models, kurz LLMs – haben KI in den Alltag gebracht. Ihre Funktionsweise lässt sich auf wenige Grundideen zurückführen. Diese Lektion geht einen Schritt tiefer als ein Überblick und zeigt die technischen Stationen vom Wort bis zur Antwort.
1. Das Grundprinzip: das nächste Token
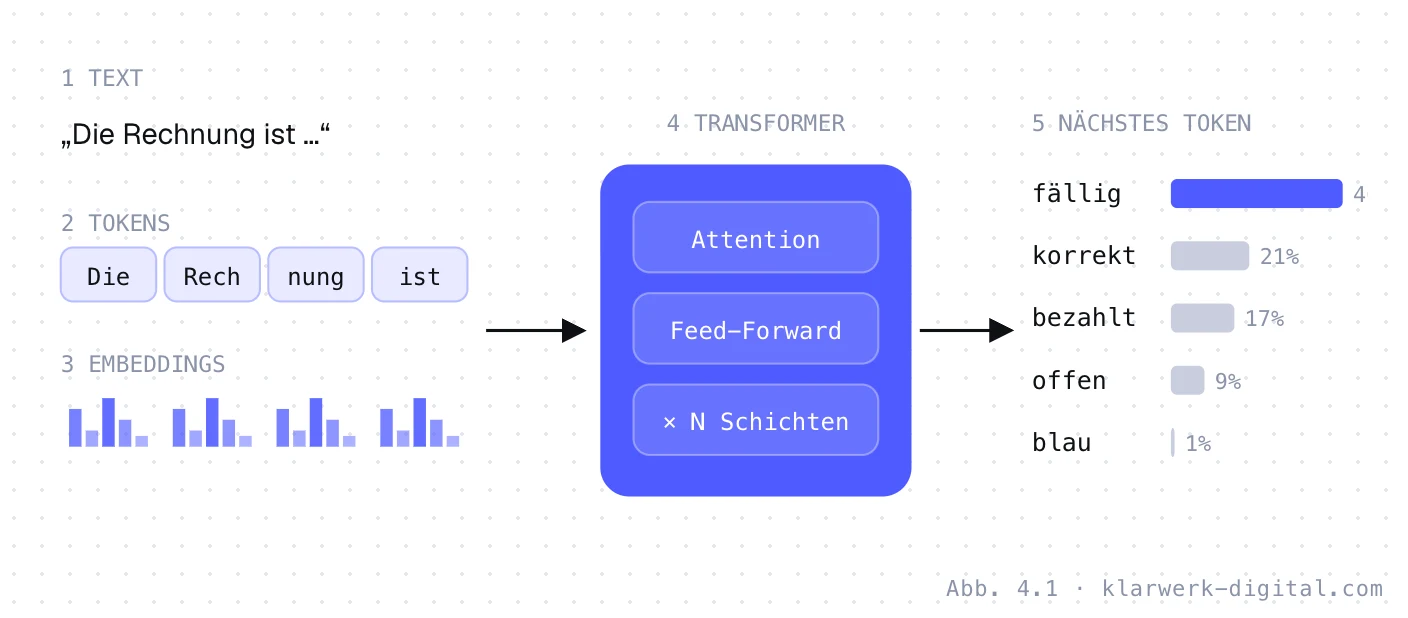
Wie die Temperatur diese Auswahl beeinflusst, können Sie im Nächstes-Wort-Labor ausprobieren.
2. Tokens und Embeddings
Tokens sind die Einheiten, mit denen ein Modell rechnet – oft ganze Wörter, bei seltenen Wörtern auch Wortteile. Ein Wort wie „Rechnungsstellung“ kann in mehrere Tokens zerfallen. Das erklärt auch, warum Modelle beim Zählen von Buchstaben oft danebenliegen: Sie sehen keine einzelnen Buchstaben.
Jedes Token wird in ein Embedding übersetzt – einen Vektor aus Hunderten oder Tausenden Zahlen. Ähnliche Bedeutungen liegen in diesem Raum nah beieinander, und Beziehungen werden zu Richtungen.
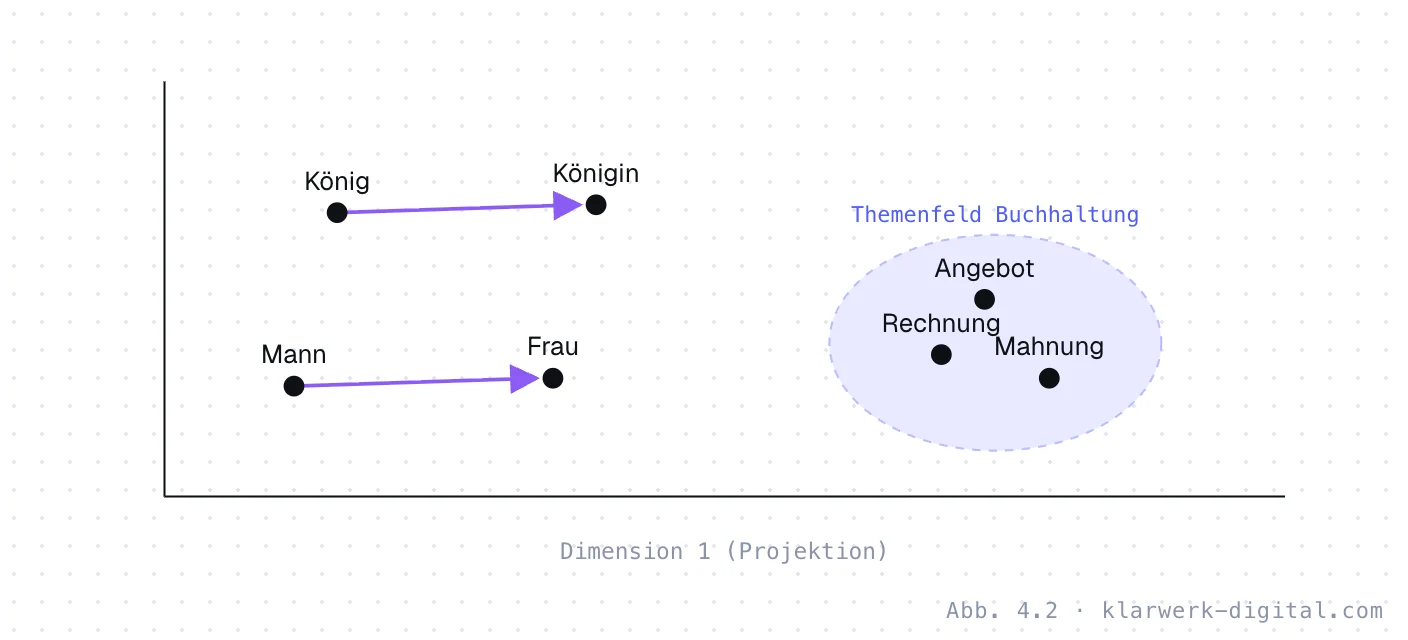
3. Aufmerksamkeit: der Kern des Transformers
Die Architektur heutiger Sprachmodelle heißt Transformer. Ihr zentraler Mechanismus ist die Aufmerksamkeit: Bei der Verarbeitung eines Wortes gewichtet das Modell, welche anderen Wörter im Text dafür relevant sind. So erkennt es etwa, worauf sich ein Pronomen bezieht.
Wählen Sie ein hervorgehobenes Wort. Die Einfärbung zeigt, wie stark es bei seiner Verarbeitung die anderen Wörter „beachtet“.
4. Wie Sprachmodelle trainiert werden
| Phase | Daten | Ziel | Ergebnis |
|---|---|---|---|
| Vortraining | sehr große Textmengen | nächstes Token vorhersagen | breites Sprach- und Weltwissen, aber kein Assistentenverhalten |
| Instruktions-Feinabstimmung | Beispiele aus Anweisung und guter Antwort | Aufgaben befolgen | Modell reagiert auf Anweisungen |
| Feedback-Training (z. B. RLHF) | menschliche Bewertungen von Antworten | hilfreich, ehrlich, harmlos antworten | Assistent mit gewünschtem Verhalten |
RLHF = Reinforcement Learning from Human Feedback. Anbieter kombinieren und variieren diese Verfahren.
5. Kontextfenster und Einstellungen
- Kontextfenster: die maximale Menge an Tokens, die ein Modell gleichzeitig berücksichtigt – Eingabe und Antwort zusammen. Was außerhalb liegt, „sieht“ das Modell nicht.
- Temperatur: steuert, wie stark bei der Auswahl des nächsten Tokens gestreut wird. Niedrig: vorhersehbar. Hoch: vielfältiger, aber fehleranfälliger.
- Wissensstand: Ein Modell kennt nur Informationen bis zum Ende seiner Trainingsdaten, sofern es nicht über Werkzeuge wie eine Suche aktuelle Quellen erhält.
Übung
- Warum kann ein Sprachmodell Schwierigkeiten haben, die Buchstaben in einem Wort zu zählen?
- Welche Trainingsphase macht aus einem reinen Textvervollständiger einen Assistenten?
Lösungshinweise
- Weil es nicht mit einzelnen Buchstaben arbeitet, sondern mit Tokens, die mehrere Buchstaben oder ganze Wörter umfassen.
- Die Feinabstimmung mit Anweisungen und menschlichem Feedback.
- [1]Mikolov, T. et al. (2013): Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781.
- [2]Vaswani, A. et al. (2017): Attention Is All You Need. NeurIPS.
- [3]Brown, T. et al. (2020): Language Models are Few-Shot Learners. NeurIPS.
- [4]Ouyang, L. et al. (2022): Training Language Models to Follow Instructions with Human Feedback. NeurIPS.
Stand: September 2026. Kursmaterial der Klarwerk Akademie – Abbildungen sind vereinfachte, schematische Darstellungen.