- den Aufbau eines künstlichen Neurons mit Gewichten, Bias und Aktivierungsfunktion erklären
- verstehen, wie aus vielen Neuronen ein tiefes Netz entsteht
- Backpropagation und Gradientenabstieg in eigenen Worten beschreiben
- einordnen, was „Parameter“ bei großen Modellen bedeuten
Neuronale Netze sind das Fundament fast aller aktuellen KI-Durchbrüche – von der Bilderkennung bis zu Sprachmodellen. Ihr Grundbaustein ist erstaunlich einfach. Die Leistungsfähigkeit entsteht erst durch die Menge und das Zusammenspiel.
1. Das künstliche Neuron
Als Formel sieht das so aus: y = f(w₁·x₁ + w₂·x₂ + b). Die Gewichte bestimmen, wie stark eine Eingabe zählt, der Bias verschiebt die Schwelle, und die Aktivierungsfunktion entscheidet, wie stark das Neuron „feuert“. Probieren Sie es aus:
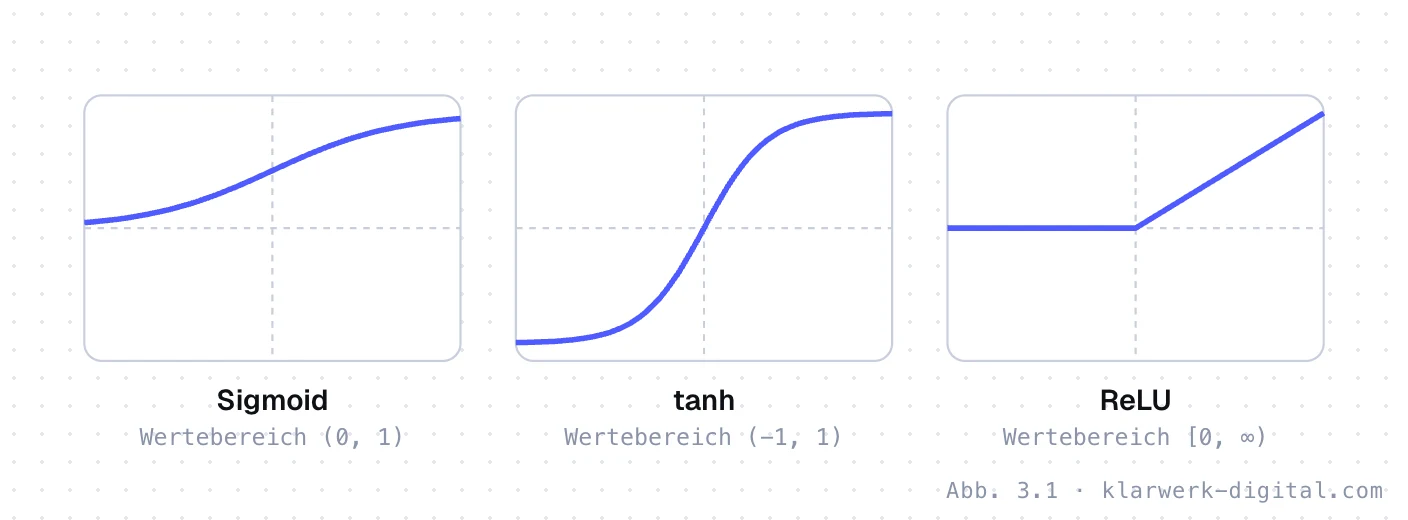
2. Aktivierungsfunktionen
Ohne Aktivierungsfunktion wäre ein noch so großes Netz nur eine einzige lineare Rechnung. Erst die nichtlineare Aktivierung erlaubt es, komplexe Zusammenhänge abzubilden.
3. Vom Neuron zum Netz
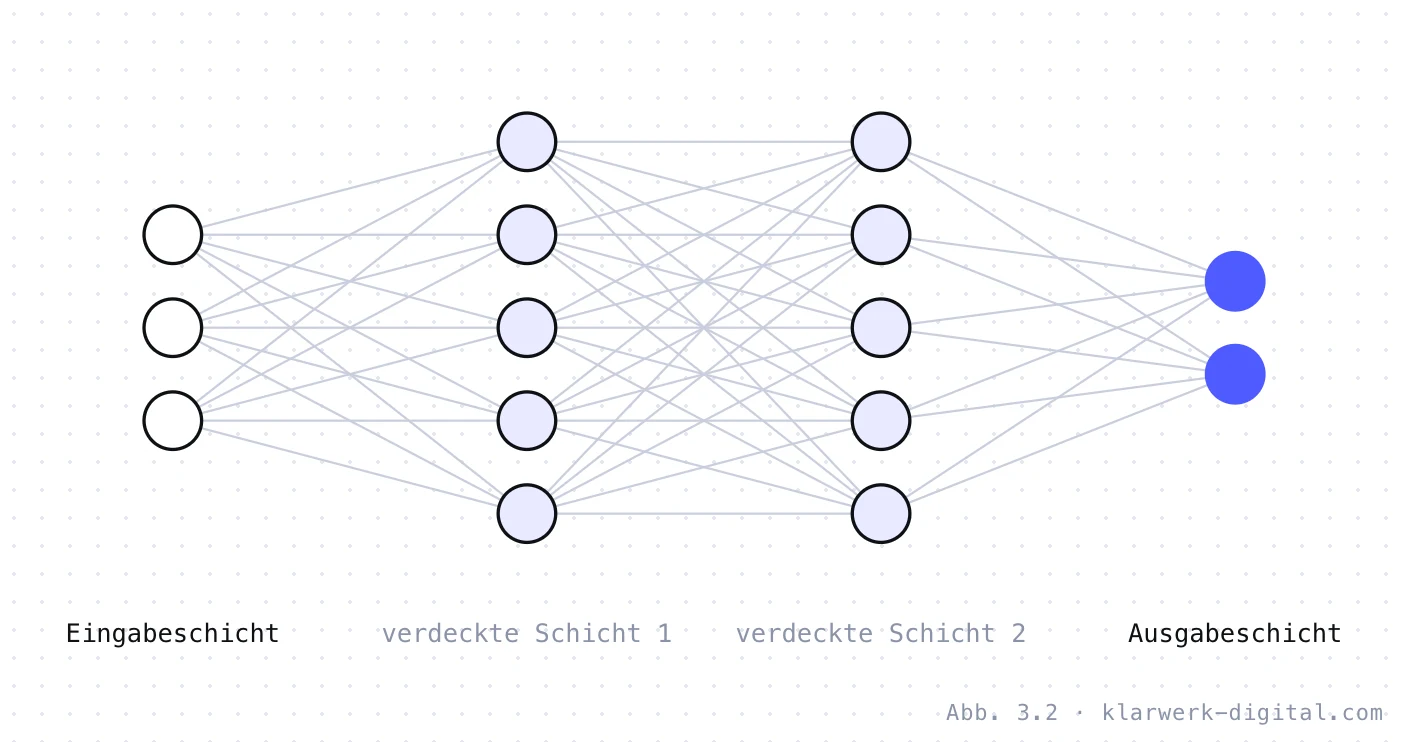
Neuronen werden in Schichten angeordnet. Die Eingabeschicht nimmt die Daten auf, verdeckte Schichten verarbeiten sie, die Ausgabeschicht liefert das Ergebnis. Von Deep Learning spricht man, wenn viele verdeckte Schichten hintereinanderliegen.
| Modell | Jahr | Parameter | Einordnung |
|---|---|---|---|
| Netz aus Abb. 3.2 | – | 62 | Lehrbeispiel |
| AlexNet | 2012 | ca. 60 Mio. | Durchbruch in der Bilderkennung |
| GPT-3 | 2020 | 175 Mrd. | großes Sprachmodell |
Für viele aktuelle Modelle veröffentlichen Anbieter keine Parameterzahlen mehr.
4. Wie ein Netz lernt
Zu Beginn sind alle Gewichte zufällig. Das Training besteht aus einer Schleife:
- Vorwärtsdurchlauf: Ein Beispiel läuft durch das Netz, am Ende steht eine Vorhersage.
- Verlust berechnen: Die Vorhersage wird mit der richtigen Antwort verglichen.
- Backpropagation: Der Fehler wird rückwärts durch das Netz verteilt. Für jedes Gewicht wird berechnet, wie stark es zum Fehler beigetragen hat – mathematisch über Ableitungen und die Kettenregel.
- Gradientenabstieg: Jedes Gewicht wird ein kleines Stück in die Richtung verändert, die den Fehler verringert.
Die Mathematik dahinter – Steigung, Ableitung und Gradient – ist anschaulicher, als sie klingt. Sie finden sie im Modul Mathe für KI.
- [1]Rosenblatt, F. (1958): The Perceptron – A Probabilistic Model for Information Storage and Organization in the Brain. Psychological Review, 65(6).
- [2]Rumelhart, D. E., Hinton, G. E., Williams, R. J. (1986): Learning Representations by Back-Propagating Errors. Nature, 323.
- [3]Goodfellow, I., Bengio, Y., Courville, A. (2016): Deep Learning. MIT Press, Kapitel 6.
- [4]Brown, T. et al. (2020): Language Models are Few-Shot Learners. NeurIPS.
Stand: September 2026. Kursmaterial der Klarwerk Akademie – Abbildungen sind vereinfachte, schematische Darstellungen.