- die drei Lernparadigmen des Machine Learning unterscheiden
- den Ablauf eines Trainings von den Daten bis zur Bewertung beschreiben
- erklären, warum Daten in Trainings-, Validierungs- und Testdaten aufgeteilt werden
- Unter- und Überanpassung erkennen
Klassische Software folgt Anweisungen, die ein Mensch Schritt für Schritt aufgeschrieben hat. Machine Learning kehrt dieses Prinzip um: Man gibt Beispiele vor, und das System leitet die Regeln selbst ab. Diese Lektion zeigt, wie das technisch funktioniert.
1. Lernen als Optimierung
Das klingt abstrakt, lässt sich aber an einem Alltagsbeispiel greifen: Ein Modell soll den Preis einer Wohnung schätzen. Anfangs rät es. Jede falsche Schätzung erzeugt einen Fehler. Ein Optimierungsverfahren verändert die Parameter des Modells ein kleines Stück in die Richtung, in der der Fehler sinkt – und wiederholt das tausendfach.
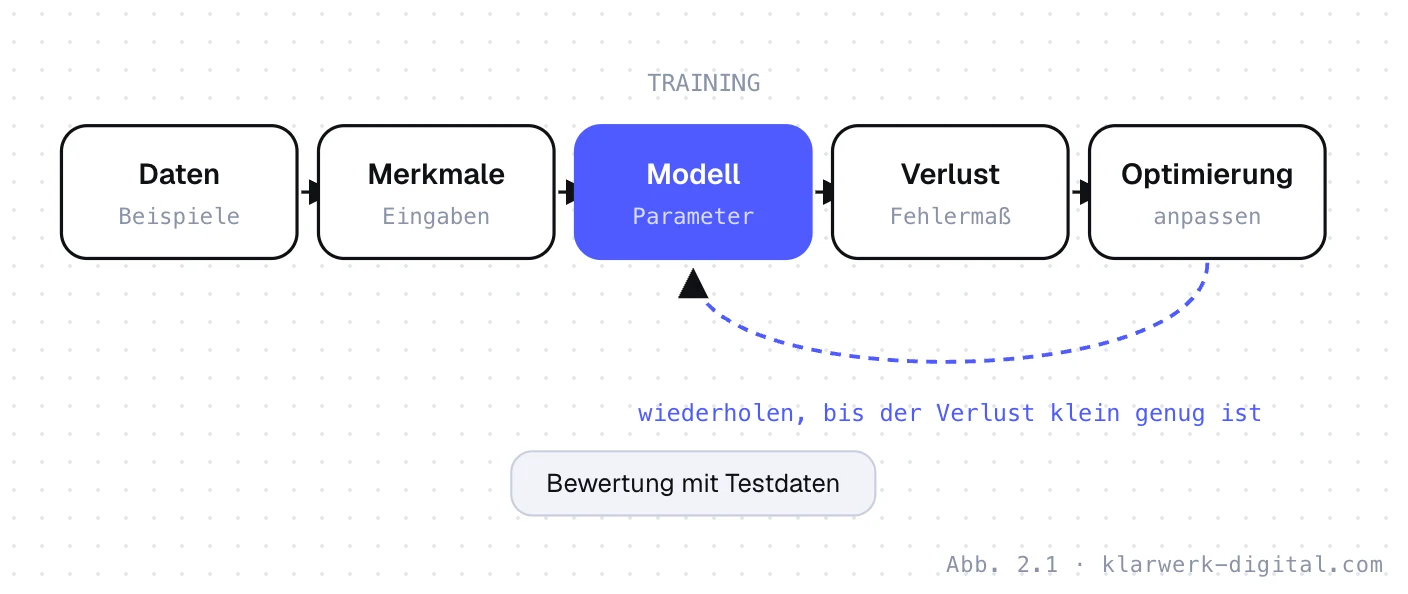
Wie das Anpassen mathematisch funktioniert, erleben Sie interaktiv in den Lektionen Lineare Regression und Ableitung als Steigung des Moduls Mathe für KI.
2. Drei Arten zu lernen
| Paradigma | Was das Modell bekommt | Typische Aufgabe | Beispiel aus der Praxis |
|---|---|---|---|
| Überwachtes Lernen | Beispiele mit richtiger Antwort (Label) | Klassifikation, Vorhersage | E-Mail ist Spam oder kein Spam |
| Unüberwachtes Lernen | Daten ohne Label | Gruppen und Strukturen finden | Kundensegmente im Shop entdecken |
| Bestärkendes Lernen | Belohnung oder Strafe für Aktionen | Strategien in Umgebungen | Spiele, Robotik, Feinabstimmung von Sprachmodellen |
Große Sprachmodelle kombinieren mehrere Paradigmen – dazu mehr in Lektion 4.
3. Trainieren, prüfen, testen
Ein Modell, das seine Trainingsbeispiele perfekt beherrscht, ist nicht automatisch gut. Entscheidend ist, wie es mit neuen Daten umgeht – die sogenannte Generalisierung. Deshalb werden Daten vorab aufgeteilt:
| Teil | Übliche Größe | Zweck |
|---|---|---|
| Trainingsdaten | ca. 70–80 % | Das Modell lernt daraus seine Parameter. |
| Validierungsdaten | ca. 10–15 % | Einstellungen vergleichen und Training rechtzeitig stoppen. |
| Testdaten | ca. 10–15 % | Einmalige, ehrliche Schlussbewertung mit unbekannten Daten. |
Die Anteile sind Richtwerte; bei sehr großen Datenmengen genügen oft kleinere Validierungs- und Testanteile.
4. Unter- und Überanpassung
Ist ein Modell zu einfach, erfasst es die Muster nicht – es ist unterangepasst. Ist es zu komplex, lernt es die Trainingsdaten samt Zufallsrauschen auswendig – es ist überangepasst und versagt bei neuen Daten.
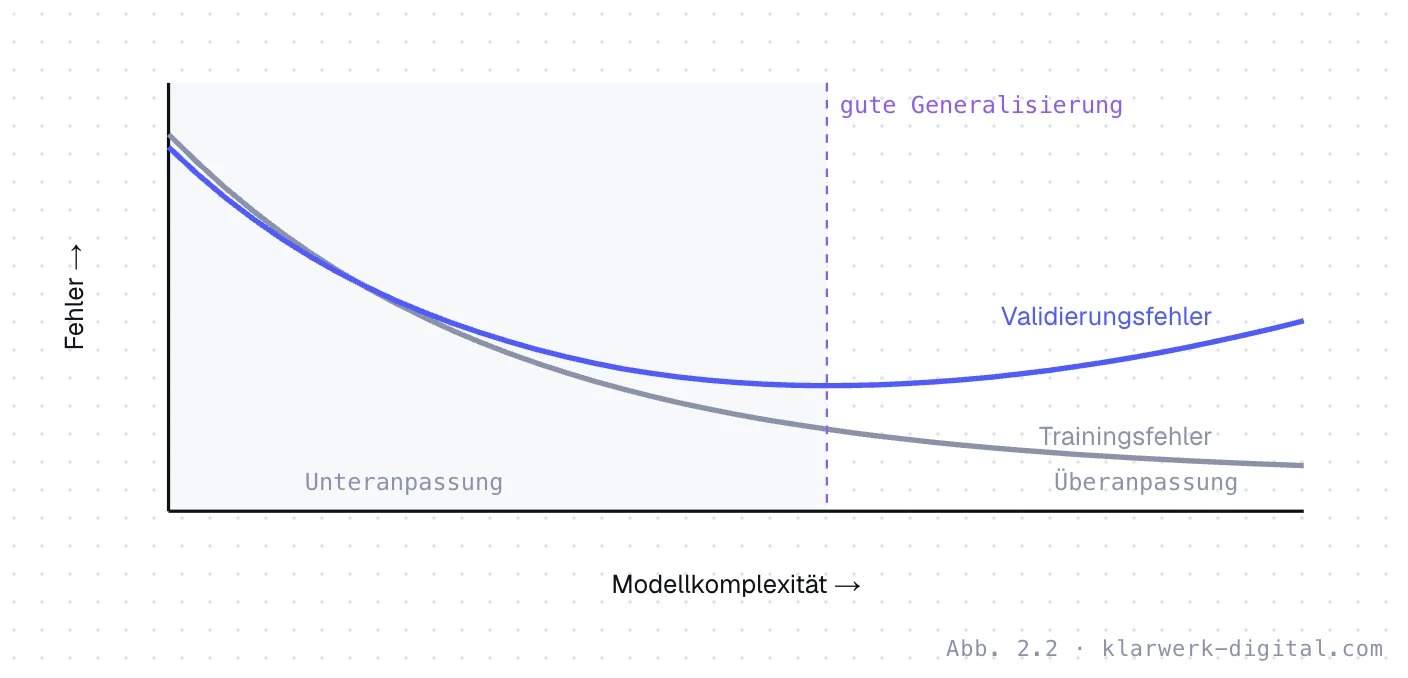
Übung
- Ein Modell erreicht 99 % Genauigkeit auf den Trainingsdaten, aber nur 61 % auf den Testdaten. Was ist passiert?
- Welches Paradigma passt: Ein System soll ohne Vorgaben Gruppen ähnlicher Supportanfragen finden?
Lösungshinweise
- Überanpassung: Das Modell hat die Trainingsdaten auswendig gelernt und generalisiert schlecht.
- Unüberwachtes Lernen, genauer: Clustering.
- [1]Goodfellow, I., Bengio, Y., Courville, A. (2016): Deep Learning. MIT Press, Kapitel 5.
- [2]Sutton, R. S., Barto, A. G. (2018): Reinforcement Learning – An Introduction. 2. Auflage, MIT Press.
- [3]Hastie, T., Tibshirani, R., Friedman, J. (2009): The Elements of Statistical Learning. 2. Auflage, Springer.
Stand: September 2026. Kursmaterial der Klarwerk Akademie – Abbildungen sind vereinfachte, schematische Darstellungen.